Cloud-Referenz
Opus 5 ULTRACODE
Cloud-Referenz · 2 Läufe
- Hardware
- Cloud-Referenz—
- Speicher
- —
- Aufgaben
- Clair Obscure, Moorhuhn, Bilderkennung
- Quantisierungen
- —
Beschreibung des Modells
Kontextfenster von 1 Million Token, zugleich Standardwert und Maximum, eine kleinere Kontextvariante gibt es laut Dokumentation nicht. Eingabe sind Text und Bilder, Ausgabe ist Text, synchron bis 128.000 Token und über die Message Batches API mit dem Beta-Header output-300k-2026-03-24 bis 300.000 Token. Adaptives Denken ist ab Werk aktiv und wird über den Parameter effort in fünf Stufen von low bis max gesteuert, Vorgabe ist high, bei xhigh und max lässt sich das Denken nicht abschalten. Anthropic nennt in der Modelldokumentation weder Parameterzahl noch Schichtzahl oder Architekturtyp, dokumentiert sind Modell-ID claude-opus-5, Veröffentlichung am 24. Juli 2026 sowie Trainingsdaten-Stichtag und verlässlicher Wissensstand Mai 2026.
- Modell-ID
- claude-opus-5
- Kontextfenster
- 1 Mio. Token (Standard und Maximum)
- Maximale Ausgabe (Messages API)
- 128K Token
- Maximale Ausgabe (Message Batches API, Beta)
- 300K Token
- Modalitäten
- Text und Bilder rein, Text raus
- Reasoning
- Adaptives Denken, standardmäßig aktiv
- Effort-Stufen
- low, medium, high, xhigh, max
- Standard-Effort
- high
Angaben des Herstellers: Quelle · Modellkarte · Hersteller
Lauf: Clair Obscure · 25. Juli 2026
Die Zahlen auf einen Blick
Der Lauf ging über eine fremde Schnittstelle. Es gibt kein Serverprotokoll, also weder Geschwindigkeit noch Tokenbilanz. Was zählt, ist das Artefakt.
Artefakt vorhanden und spielbar. Geschwindigkeit in der Cloud nicht vergleichbar messbar.
Ergebnisse
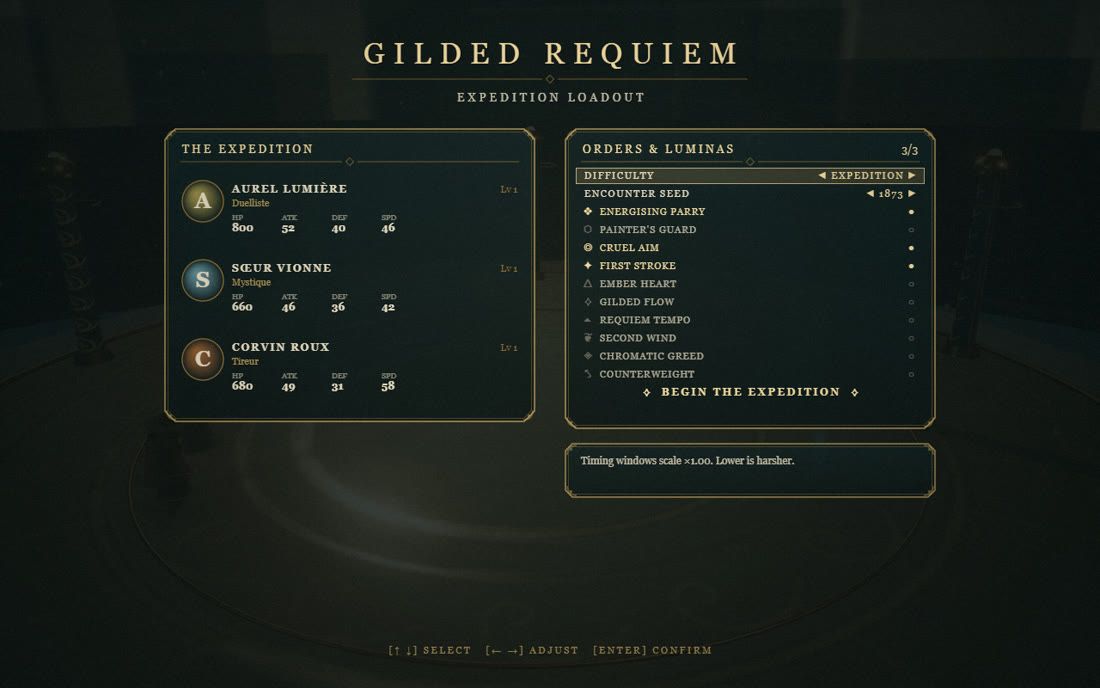
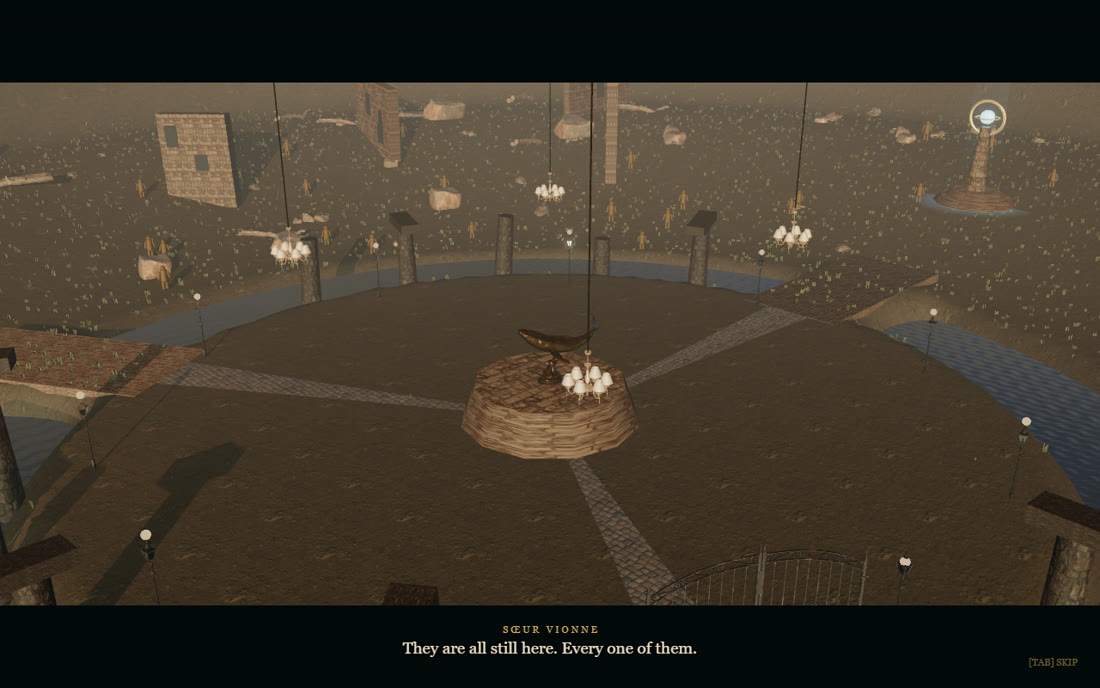
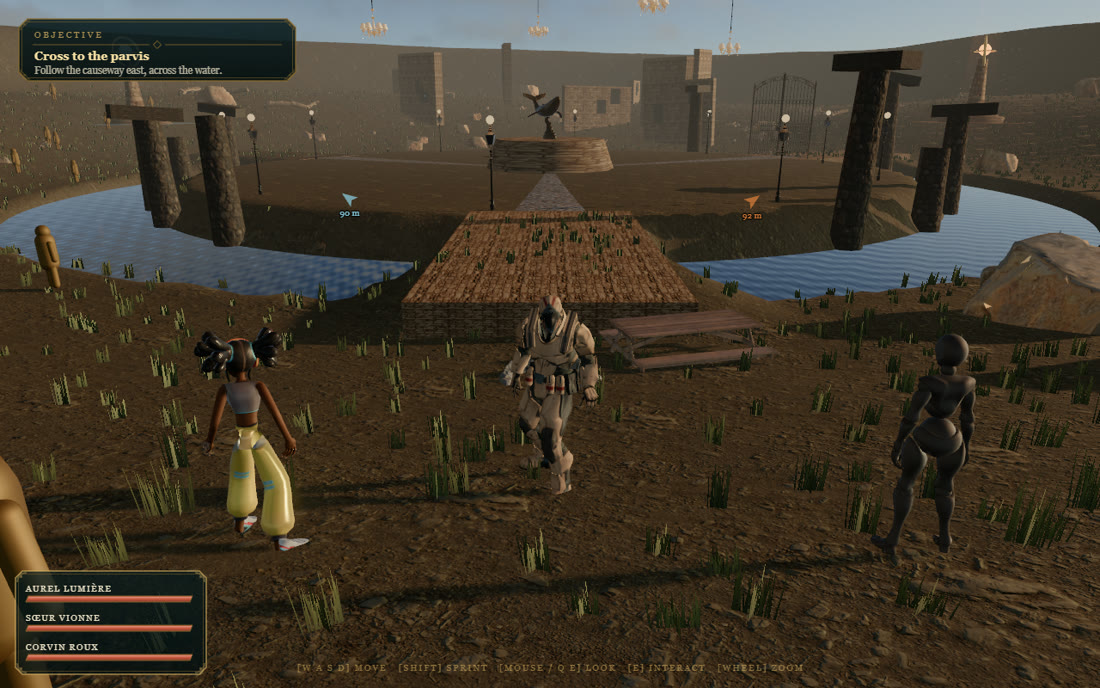
Für diesen Lauf liegt kein spielbarer Build vor.
Einordnung
34 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
10/10
Spielbar, die vollständigste Umsetzung des Auftrags im Feld.
PräsentationMenüs, Anzeigen, Grafik, Ton
10/10
Aufnahme mit Ladebildschirm, Kampf und Menüs.
CodequalitätTests, Struktur, Selbstkorrekturen
4/10
Keine Testdateien.
UmfangWie viel vom Auftrag wurde erfüllt?
10/10
58 Dateien, 16 308 Zeilen, mit Abstand der größte Umfang.
Diese Bewertung ist ein Vorschlag und von Kai Bennett noch nicht bestätigt. Codequalität und Umfang stützen sich auf ausgezählte Dateien, Quell- und Testzeilen sowie Reparaturskripte im Belegrepo.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
- Das Spiel lädt drei GLB-Modelle und eine 4K-HDRI nach; auf schwachen Verbindungen dauert der erste Start über zehn Sekunden.
- Eine Ressource fehlt und liefert 404 — sichtbar in der Browserkonsole, ohne Wirkung auf das Bild.
- Die Steuerung setzt Tastatur voraus. Auf Tastbildschirmen ist das Spiel nicht bedienbar.
Artefakt vorhanden und spielbar. Geschwindigkeit in der Cloud nicht vergleichbar messbar.
Lauf: Moorhuhn · 02. September 2026
Die Zahlen auf einen Blick
Dieser Lauf steht noch aus. Es liegt nur der Auftrag vor, keine Messung und kein Artefakt.
Kein Lauf, keine Zahlen.
Einordnung
noch nicht bewertet
Die Note ist eine persönliche also subjektive Einschätzung.
Für diesen Lauf liegt kein bewertbares Artefakt vor, deshalb steht hier keine Note.
Was schiefging
Keine Selbstkorrekturen protokolliert.
Kein Lauf, keine Zahlen.
Bilderkennung
Der Lösungsschlüssel für den Bilderkennungs-Test wurde von Opus 5 selbst geschrieben. Eine eigene Trefferquote wäre zirkulär und wird deshalb nicht ausgewiesen. Der Nachbau des Diagramms steht trotzdem hier — als Beispiel dafür, was in diesem Abschnitt erwartet wird.
Quellen
- Modellkartedocs.anthropic.com/en/docs/about-claude/models
- Herstellerseitewww.anthropic.com
- Messdaten-Repogithub.com/KaiFelixBennett/local-ai-amd-benchmark
- Quelltext · Clair Obscuregithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/opus5/clairobscure
Selbst ausprobieren
- Gewichte laden
- llama-server mit der Startzeile oben starten
- Den Endpunkt in VS Code als eigenes Modell eintragen und den Agenten wählen
Auftrag, Agentdateien und Werkzeuge: Agent Test Harness
Zitieren: Kai Felix Bennett, „Nutzbarkeitstest von lokaler KI auf AMD-Hardware", benchmark.securesight.ai, Lauf opus5-clairobscure. Messdaten CC-BY-4.0.
Messdaten CC-BY-4.0, Code MIT.