Lokal gelaufen
Qwen3.5-122B-A10B
AMD AI MAX 395 (AMD Halo) · GMKtec EVO-X2
- Hardware
- AMD AI MAX 395 (AMD Halo) · GMKtec EVO-X2Strix Halo · Radeon 8060S · gfx1151
- Speicher
- 128 GiB unified
- Aufgaben
- Labortest, Bilderkennung
- Quantisierungen
- UD-Q4_K_XL
Beschreibung des Modells
Sparse Mixture-of-Experts mit 122 Milliarden Parametern gesamt und 10 Milliarden aktiv je Token. Die Modellkarte gibt 48 Schichten im Muster 12 × (3 × (Gated DeltaNet → MoE) → 1 × (Gated Attention → MoE)) an, also drei Gated-DeltaNet-Schichten auf eine Gated-Attention-Schicht. Jede MoE-Schicht enthält 256 Experten, aktiv sind davon 8 geroutete plus 1 geteilter Experte. Als Typ nennt die Karte "Causal Language Model with Vision Encoder", die native Kontextlänge beträgt 262 144 Token und ist laut Karte bis 1 010 000 Token erweiterbar.
- Typ
- Causal Language Model with Vision Encoder (Sparse MoE)
- Gesamtparameter
- 122 B
- Aktive Parameter je Token
- 10 B
- Schichten
- 48
- Experten je MoE-Schicht
- 256
- Aktive Experten
- 8 geroutet + 1 geteilt
- Kontextlänge
- 262 144 Token nativ, erweiterbar bis 1 010 000 Token
- Lizenz
- apache-2.0
Angaben des Herstellers: Quelle · Modellkarte · Hersteller
Die Zahlen auf einen Blick
Synthetischer Labortest mit pp512 und tg128, kein Agentenlauf. Die Geschwindigkeit stammt daher aus einer Messreihe, nicht aus gewerteten Antworten eines echten Laufs. Eine Tokenbilanz und eine Kurve über die Kontexttiefe gibt es nicht, beides setzt viele aufeinanderfolgende Anfragen voraus. Das Artefakt daneben stammt aus einem eigenen Durchgang desselben Modells.
Decode mit MTP
31,80 t/s
Entwurfstiefe 2, ein einzelner Prompt, das 1,55fache des Werts ohne Spekulation
Decode bei den Aufgaben
26,5 bis 28,0 t/s
mit MTP, Entwurfstiefe 2, über die fünf Programmieraufgaben
Decode ohne Spekulation
20,52 t/s
llama-bench tg128
Annahme der Entwürfe
0,866
bei Entwurfstiefe 2, im Mittel 2,73 Token je Schritt
Prefill bei 512 Token
245,71 t/s
llama-bench pp512
Prefill bei 4 096 Token
232,68 t/s
nur 5 Prozent unter dem Wert bei 512 Token
Programmieraufgaben
5 von 5
gegen versteckte Tests ausgeführt, 1 232 Sekunden gesamt
Gewichte
73,23 GiB
UD-Q4_K_XL, 124,64 Mrd. Parameter, rund 10 Mrd. aktiv
Synthetisch: llama-bench pp512, pp4096 und tg128, dazu llama-server für die Spekulation. Messreihe vom 23.07.2026. · Rohprotokoll
Ergebnisse
Das Spiel, das dieser Lauf abgeliefert hat, startet nicht: drei Syntaxfehler brechen das Laden ab, übrig bleibt ein schwarzer Bildschirm. Deshalb gibt es hier weder eine Aufnahme noch eine Version zum Ausprobieren. Der Quelltext liegt so, wie das Modell ihn abgegeben hat, im Belegrepo.
Messreihen
Geschwindigkeit über die Entwurfstiefe
MTP sagt mehrere Token auf einmal voraus, und das Modell prüft sie in einem Schritt. Wie viele es je Schritt versucht, stellt --spec-draft-n-max ein. Mehr ist nicht automatisch schneller: bei 6 wird so viel verworfen, dass der Gewinn schrumpft.
llama.cpp Startparameter
- Kontext
- 262.144
- KV-Cache
- q8_0 / q8_0
- Micro-Batch
- 512
- Spekulativ
- draft-mtp · n_max 2 · Annahme 0,866
- Build
- 04b2b72
llama-server -m Qwen3.5-122B-A10B-UD-Q4_K_XL-00001-of-00003.gguf ^
  --mmproj mmproj-F16.gguf --host 127.0.0.1 --port 8098 ^
  -c 262144 -ngl 999 -fa on ^
  -ctk q8_0 -ctv q8_0 -b 2048 -ub 512 ^
  --spec-type draft-mtp --spec-draft-n-max 2 ^
  --temp 0.6 --top-p 0.95 --presence-penalty 1.5 ^
  --jinja --chat-template-file qwen-fixed-v21.3.jinja ^
  --reasoning on --reasoning-format deepseek
Einordnung
4 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
0/10
Das Spiel startet nicht. Drei Syntaxfehler brechen das Laden ab, es bleibt ein schwarzer Bildschirm.
PräsentationMenüs, Anzeigen, Grafik, Ton
0/10
Davon ist nichts zu sehen: ohne lauffähigen Build keine Menüs, keine Grafik, kein Ton.
CodequalitätTests, Struktur, Selbstkorrekturen
2/10
Keine Tests, und drei Syntaxfehler, die ein einziger Start sofort gezeigt hätte.
UmfangWie viel vom Auftrag wurde erfüllt?
2/10
Angelegt ist viel: Kampfsystem, Reaktionen, Zielauswahl, Zugreihenfolge, Ton und Nachbearbeitung in 6 537 Zeilen. Erfüllt ist davon im Ergebnis nichts, weil das Spiel nicht startet.
Diese Bewertung ist ein Vorschlag und von Kai Bennett noch nicht bestätigt. Codequalität und Umfang stützen sich auf ausgezählte Dateien, Quell- und Testzeilen sowie Reparaturskripte im Belegrepo.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
- Das ausgelieferte Spiel startet nicht. Das Modell hat drei Schleifen von forEach auf for umgeschrieben und dabei jedes Mal das alte }); stehen lassen: in damage-numbers.js Zeile 142, hud.js Zeile 263 und prompts.js Zeile 274. Jede dieser Stellen bricht das Laden des ganzen Spiels ab, übrig bleibt ein schwarzer Bildschirm.
- Mit Unsloths Voreinstellung für präzises Programmieren, presence_penalty 0,0, hat das Modell eine Aufgabe nie beendet: 32 768 Token über 1 087 Sekunden, ohne Antwort. Laguna löst dieselbe Aufgabe in 201 Token. Mit presence_penalty 1,5 bei Temperatur 0,6 kommt es mit 7 680 Token in 297 Sekunden zum Ziel. Der erste Durchgang der Programmieraufgaben ist deshalb ungültig.
- Unsloths Beispielwert für die Entwurfstiefe, 6, liegt 13 Prozent unter dem gemessenen Optimum.
- Bei den Programmieraufgaben dasselbe Ergebnis wie Laguna, aber 67 Prozent langsamer: das Modell denkt bei jeder Aufgabe 3 000 bis 6 600 Token nach, auch bei den eindeutig beschriebenen, und erzeugt so 2,3 mal so viele Token.
- Nicht geprüft ist, ob MTP unter echter Agentenlast hält. Bei Laguna brach die Annahme der Entwürfe genau dort auf null ein. Die 31,80 t/s stammen aus einem einzelnen Prompt.
- Noch nicht gemessen: die Geschwindigkeit über die Kontexttiefe und Tool Calling.
- Bei der zweiten Bildaufgabe hat das Modell kein einziges Preisschild lesen können. Es hat das selbst gesagt und nichts erfunden.
Synthetisch: llama-bench pp512, pp4096 und tg128, dazu llama-server für die Spekulation. Messreihe vom 23.07.2026.
Bilderkennung
Eigener Testlauf mit demselben Modell auf derselben Maschine, nicht Teil des Laufs, in dem das Spiel entstand.
Werte ablesen
30 von 50
Dashboard, 50 prüfbare Angaben
Preisschilder
0 von 4
vollständig richtig gelesen
Erfundene Schilder
0
keins als sicher behauptet
Fallen bestanden
1 von 4
Stellen, die vom Muster abweichen
Vorläufig: der Lösungsschlüssel für die Preisschilder ist noch nicht vollständig gesichert.
Aufgabe 1 · Werte ablesen
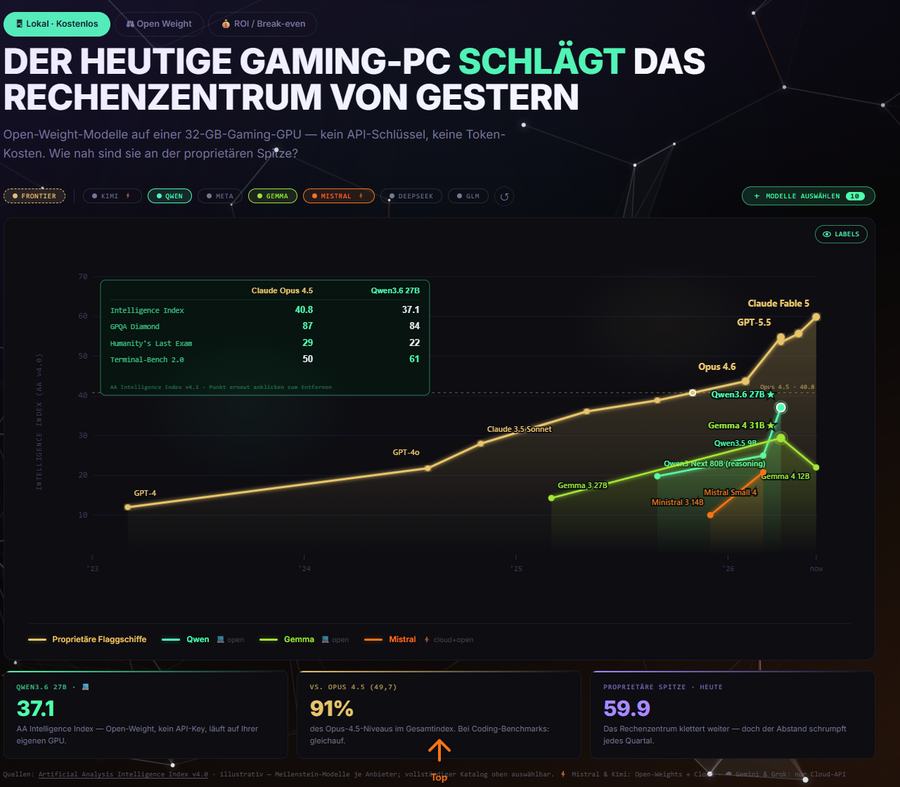
Was das Modell aus der Tooltip-Tabelle gelesen hat
| Claude Opus 4.5 | Qwen3.5 27B | |
|---|---|---|
| Intelligence Index | 40.8 | 37.1 |
| GPQA diamond | 87 | 84 |
| Humanity's Last Exam | 29 | 22 |
| Terminal-bench 2.0 | 50 | 61 |
Und aus den Kennzahlkacheln
- QWEN3.5 27B 37.1 · AI Intelligence Index — Open-Weight, kein API-Key, läuft auf der eigenen GPU
- VS. OPUS 4.5 (49.7) 91 · des Opus-4.5-Niveaus im Gesamtindex. Bei Coding-Benchmarks: gleichauf.
- PROPRIETÄRE SPITZE · HEUTE 59.9 · Das Rechenzentrum klettert weiter — doch der Abstand schrumpft jedes Quartal.
Aufgabe 2 · Komplexe Schrifterkennung
Geprüft wird das Lesen von winzigen, schräg stehenden, teils verdeckten Schriften in einem Foto mit über vierzig Objekten, dazu zwei Währungszeichen, die sich bei starker Drehung kaum unterscheiden. Zum Test werden die Preisschilder verwendet.
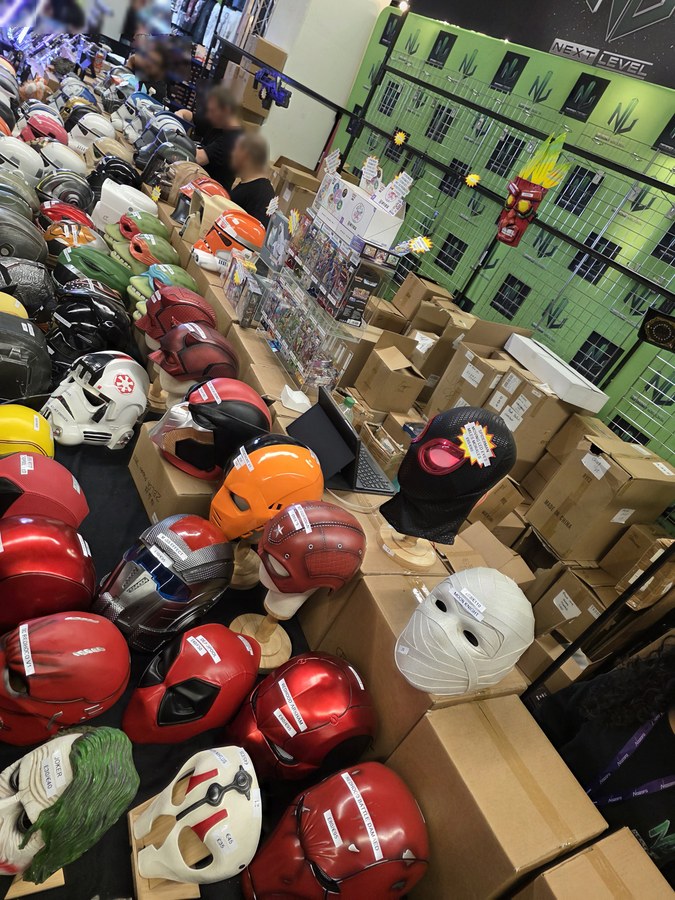
Was das Modell gelesen hat
Keine Schilder genannt.
Das Modell über die schwierigste Stelle: „Die Preisschilder im unteren linken Bereich (Wertungsbereich: x<700, y>950) sind extrem unscharf, gedreht und teilweise verdeckt. Keine einzige Zahl war sicher lesbar.“
Wo sich das Modell selbst unsicher war (3 Stellen)
- Alle Preisschilder in Bild B - keine Zahlen konnten sicher gelesen werden
- Genaue Positionsbestimmung welches Schild im Wertungsbereich liegt bei dieser Perspektive
- Unterscheidung von £ und € bei gedrehten Schildern
Diese Liste hat das Modell selbst geschrieben, nicht der Auswerter. Sie zählt in die Wertung: ein eingestandenes „nicht lesbar“ kostet einen Punkt, eine erfundene Angabe kostet mehr.
Die vollständige Antwort des Modells als JSON · Die Auswertung dazu steht nicht daneben: sie nennt zu jedem Fehler den richtigen Wert, und damit läge der Lösungsschlüssel offen.
Quellen
- Modellgewichtehuggingface.co/unsloth/Qwen3.5-122B-A10B-GGUF
- Modellkartehuggingface.co/Qwen/Qwen3.5-122B-A10B
- Herstellerseiteqwen.ai
- Messdaten-Repogithub.com/KaiFelixBennett/local-ai-amd-benchmark
- Rohprotokoll dieses Laufsgithub.com/KaiFelixBennett/local-ai-amd-benchmark/blob/main/evidence/reports/qwen35-122b-a10b-strix-halo-vulkan-benchmark.md
- Quelltext · Labortest · UD-Q4_K_XL · Reasoning an, ohne Begrenzunggithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/qwen35-122b-a10b/clairobscure
Selbst ausprobieren
- Gewichte laden · Bezugsquelle
- llama-server mit der Startzeile oben starten
- Den Endpunkt in VS Code als eigenes Modell eintragen und den Agenten wählen
Auftrag, Agentdateien und Werkzeuge: Agent Test Harness
Zitieren: Kai Felix Bennett, „Nutzbarkeitstest von lokaler KI auf AMD-Hardware", benchmark.securesight.ai, Lauf qwen35-122b-a10b-evox2. Messdaten CC-BY-4.0.
Messdaten CC-BY-4.0, Code MIT.