Lokal gelaufen
Qwen3.6-27B
Radeon AI PRO R9700 · 2 Läufe
- Hardware
- Radeon AI PRO R9700gfx1201 · RDNA4
- Speicher
- 32 GB dediziert
- Aufgaben
- Moorhuhn, Clair Obscure, Bilderkennung
- Quantisierungen
- UD-Q6_K_XL
Persönliche Meinung
Kai Bennett
Das Modell hat in der Kombination mit dem Hermes Agent und dem Telegram Gateway erstaunlich gut für mich funktioniert. Über das in Hermes integrierte Telegram Gateway bekommt man eine gut nutzbare Fernsteuerung seines PCs, kostenlos, in dem Setting sogar per Sprache steuerbar inklusive Bilderkennung. Das Setup ist eine gute Chat Alternative zu den großen Anbietern, völlig kostenlos und ohne alle Daten zu teilen. Auch Tool Use, z.B. der Abruf von tagesaktuellen Daten per Websuche funktioniert erstaunlich gut. Beim Coding erledigt es kleinere Tasks autonom in meist nutzbarer Qualität.
Aus meiner Einschätzung zum Nachfolger Qwen3.8-27B. Eine eigene Bewertung des 3.6ers steht noch aus.
Beschreibung des Modells
Dichtes Modell mit 27 Milliarden Parametern, 64 Schichten, Hidden Dimension 5120 und 262 144 Token nativem Kontext, laut Modellkarte erweiterbar bis 1 010 000 Token. Die Schichten folgen dem Muster 16 × (3 × (Gated DeltaNet → FFN) → 1 × (Gated Attention → FFN)), die config.json nennt dazu full_attention_interval 4. Gated Attention arbeitet mit 24 Query-Heads und 4 Key/Value-Heads bei Head-Dimension 256, Gated DeltaNet mit 48 Value-Heads und 16 QK-Heads bei Head-Dimension 128, die FFN-Zwischendimension beträgt 17408. Als Typ nennt die Modellkarte "Causal Language Model with Vision Encoder" und führt Multi-Token Prediction als Trainingsbestandteil auf.
- Architekturform
- Dicht (nur über den Aufsatztitel der Karte belegt)
- Parameter
- 27B
- Schichten
- 64
- Schichtmuster
- 16 × (3 × (Gated DeltaNet → FFN) → 1 × (Gated Attention → FFN))
- Kontextlänge
- 262 144 Token nativ, erweiterbar bis 1 010 000 Token
- Multi-Token Prediction
- mit mehreren Schritten trainiert (MTP)
- Lizenz
- Apache-2.0
Angaben des Herstellers: Quelle · Modellkarte · Hersteller
Lauf: Moorhuhn · UD-Q6_K_XL · Reasoning an, Budget 20000 Token · 02. September 2026
Die Zahlen auf einen Blick
Decode, Median
33,45 t/s
221 gewertete Antworten
Decode, p10 bis p90
29,02–38,25 t/s
Antworten ab 200 Tokens werden gewertet; kürzere erzeugen im Protokoll Ausreißer bis über 1 000 000 t/s, weil dort ein einzelnes Token in nahezu null Millisekunden fällt. Median klassisch, Perzentile nach Rangplatz. Beim Prefill gilt diese Schwelle NICHT, dort zählt jede Auswertung.
Spitze
41,39 t/s
einzelne Antwort
Prefill, Median
152,7 t/s
Ausgabe erzeugt
175.743 Token
nur die gewerteten Antworten ab 200 Tokens
Laufzeit
2,5 h
153 Minuten
Selbstkorrekturen
12
Antworten gesamt
409
221 davon gewertet
Eingabe gesamt
28,66 Mio. Token
Kontext aller 409 Anfragen zusammengezählt
davon neu berechnet
546.453 Token
28,11 Mio. lagen im Prompt-Cache
Durch das Modell gelaufen
28,86 Mio. Token
Eingabe und Ausgabe zusammen
Bei einem Anbieter
1,40 USD
Qwen3.6-27B gehostet, günstigster Tarif
Was dieser Lauf gekostet hätte, wenn Qwen3.6-27B bei einem Anbieter gelaufen wäre
| Anbieter | Eingabeje Mio. | Ausgabeje Mio. | Cacheje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|
| Chutes | 0,30 | 2,00 | 0,030 | 8,99 | 1,40 |
| SiliconFlow | 0,30 | 3,20 | · | 9,23 | · |
| Phala | 0,32 | 2,70 | 0,150 | 9,70 | 4,92 |
| Alibaba Cloud Int. | 0,45 | 2,70 | · | 13,43 | · |
Alle Beträge in USD. Die ersten drei Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit denselben Token wie links: 28 659 296 Eingabe über alle Anfragen, davon 546 453 neu berechnet und 28 112 843 aus dem Prompt-Cache, dazu 196 543 Ausgabe. Die Spalte „ohne Cache“ setzt die ganze Eingabe zum Eingabetarif an, die Spalte „mit Cache“ rechnet den zwischengespeicherten Teil zum Cache-Tarif des Anbieters. Anbieter mit Cache-Tarif sind der Regelfall, deshalb ist die rechte Spalte die realistischere. Es sind die Preise für Qwen3.6-27B selbst, bei Anbietern die genau dieses Modell hosten, nicht die eines fremden Cloud-Modells. Stand 08.09.2026, Listenpreise ohne Mengenrabatt. Lokal kostet der Lauf statt dessen Strom und die Anschaffung der Karte. Preise bei OpenRouter, abgerufen am 2026-09-08.
Was dieser Lauf gekostet hätte, wenn Sonnet 5 mit gleichem Tokenverbrauch gelaufen wäre
| Modell | Eingabeje Mio. | Ausgabeje Mio. | Cache schreibenje Mio. | Cache lesenje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|---|
| Sonnet 5 | 2,00 | 10,00 | 2,50 | 0,20 | 59,28 | 8,95 |
Alle Beträge in USD. Die ersten vier Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit genau den Token dieses Laufs: 28 659 296 Eingabe, davon 546 453 neu und 28 112 843 aus dem Cache, dazu 196 543 Ausgabe. Ohne Cache zum Eingabetarif, mit Cache zahlt der neue Teil den Schreibtarif und der zwischengespeicherte den Lesetarif. Das ist ein Vergleich unter der Annahme gleichen Tokenverbrauchs. Ein anderes Modell löst dieselbe Aufgabe mit anderer Tokenzahl, meist mit weniger; die Zeile sagt also, was diese Token bei Sonnet 5 gekostet hätten, nicht was Sonnet 5 für diese Aufgabe gekostet hätte. Preisliste von Anthropic, abgerufen am 2026-09-08.
llama.cpp-Serverlog · 221 von 409 Antworten ab 200 Tokens. Der Server lief 3 h 56 min am Stück; darin liegen vier Pausen von zusammen 82,0 Minuten, in denen nichts gerechnet wurde. Das Arbeitsfenster ohne diese Pausen sind 153,2 Minuten, also rund 2 h 33 min. Die reine Rechenzeit auf der GPU beträgt davon 139,1 Minuten. · Rohprotokoll
Ergebnisse
Moorland Mayhem — Featherstorm
Öffnet in einer eigenen EbeneZielen und schießen mit Maus oder Finger. Braucht WebGL.
Lädt erst auf Klick · 0,3 MB Übertragung · 1,5 MB entpackt
Prefill über Kontexttiefe
Ein Spitzenwert bei kurzem Kontext sagt wenig darüber, wie sich ein Modell nach Stunden anfühlt.
Kontexttiefe in tausend Token · Momentanrate innerhalb eines einzigen durchgehenden Prefills: Aufgabe 39083 dieses Laufs verarbeitete 43 238 Token am Stück. llama.cpp meldet dabei alle 2 048 Token einen Zwischenstand; die Rate ist der Quotient aus Token und Zeit zwischen zwei aufeinanderfolgenden Ständen. Von 23 Zwischenstücken bleiben 19 übrig, vier Reststücke unter 1 500 Token sind verworfen, weil dort der Aufruf-Overhead misst statt der Tiefe. Der Abfall ist über alle 19 Schritte monoton, ohne Ausreißer. Gezeichnet ist jeder dritte davon, sieben Punkte, Anfang und Ende inbegriffen. Von 3 K auf 41 K fällt die Rate um den Faktor 1,44. Jeder Punkt ist aus dem verlinkten Serverprotokoll nachrechenbar.
llama.cpp Startparameter
- Kontext
- 172.032
- KV-Cache
- q8_0 / q4_0
- Micro-Batch
- 512
- Spekulativ
- draft-mtp · n_max 2
- Build
- b9985
llama-server -m Qwen3.6-27B-UD-Q6_K_XL-mtp.gguf ^
  --mmproj mmproj-F16.gguf --alias Qwen3.6-27B ^
  --host 127.0.0.1 --port 8080 ^
  -c 172032 -ngl 99 -fa on ^
  -ctk q8_0 -ctv q4_0 -b 2048 -ub 512 ^
  --parallel 1 --kv-unified ^
  --ctx-checkpoints 4 --checkpoint-min-step 16384 --cache-ram 16384 ^
  --spec-type draft-mtp --spec-draft-n-max 2 ^
  --temp 0.6 --top-p 0.95 --top-k 20 --min-p 0.0 ^
  --jinja --chat-template-file qwen-fixed-chat_template.jinja ^
  --reasoning on --reasoning-format deepseek --reasoning-budget 20000
Einordnung
20 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
6/10
Der Trefferbereich saß erst nach zwölf Anläufen. Schlecht spielbar und macht keinen Spaß
PräsentationMenüs, Anzeigen, Grafik, Ton
6/10
Aufnahme vorhanden, Menüs schlichter als beim Nachfolger.
CodequalitätTests, Struktur, Selbstkorrekturen
2/10
Kein einziger echter Test, die einzige Testdatei ist die vitest-Konfiguration mit 15 Zeilen. Dafür zwölf Reparaturskripte mit zusammen 557 Zeilen, viermal fix_coords, dreimal fix_hit, alle am selben Koordinaten- und Trefferproblem.
UmfangWie viel vom Auftrag wurde erfüllt?
6/10
39 Dateien, 6 888 Zeilen. Es fehlen die Tests und einige Details.
Diese Bewertung ist ein Vorschlag und von Kai Bennett noch nicht bestätigt. Codequalität und Umfang stützen sich auf ausgezählte Dateien, Quell- und Testzeilen sowie Reparaturskripte im Belegrepo.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
Es gab zwölf Selbstkorrekturen des Modells.
llama.cpp-Serverlog · 221 von 409 Antworten ab 200 Tokens. Der Server lief 3 h 56 min am Stück; darin liegen vier Pausen von zusammen 82,0 Minuten, in denen nichts gerechnet wurde. Das Arbeitsfenster ohne diese Pausen sind 153,2 Minuten, also rund 2 h 33 min. Die reine Rechenzeit auf der GPU beträgt davon 139,1 Minuten.
Lauf: Clair Obscure · UD-Q6_K_XL · Reasoning an, Budget 20000 Token · 23. Juli 2026
Die Zahlen auf einen Blick
Kein Serverprotokoll mitgeschrieben, deshalb weder Geschwindigkeit noch Tokenzahl. Belegt sind allein das Modell und der Aufbau, über das Startskript, und das Artefakt selbst.
Nachprüfbar ist das Fehlen selbst: das Belegrepo führt für diesen Lauf unter LAUF.md „Rohprotokoll: keins“, und die Prüfsummenliste evidence/SHA256SUMS enthält sechs Protokolle, keines davon für Qwen3.6 mit Clair Obscure. Gearbeitet wurde zwischen dem 23. und dem 27. Juli 2026.
Ergebnisse
Für diesen Lauf liegt kein spielbarer Build vor.
llama.cpp Startparameter
- Kontext
- 172.032
- KV-Cache
- q8_0 / q4_0
- Micro-Batch
- 512
- Spekulativ
- draft-mtp · n_max 2
- Build
- b9985
llama-server -m Qwen3.6-27B-UD-Q6_K_XL-mtp.gguf ^
  --mmproj mmproj-F16.gguf --alias Qwen3.6-27B ^
  --host 127.0.0.1 --port 8080 ^
  -c 172032 -ngl 99 -fa on ^
  -ctk q8_0 -ctv q4_0 -b 2048 -ub 512 ^
  --parallel 1 --kv-unified ^
  --ctx-checkpoints 4 --checkpoint-min-step 16384 --cache-ram 16384 ^
  --spec-type draft-mtp --spec-draft-n-max 2 ^
  --temp 0.6 --top-p 0.95 --top-k 20 --min-p 0.0 ^
  --jinja --chat-template-file qwen-fixed-chat_template.jinja ^
  --reasoning on --reasoning-format deepseek --reasoning-budget 20000
Einordnung
22 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
6/10
Artefakt liegt vor und startet, ein rundenbasierter Kampf. Ohne Protokoll ist über den Ablauf des Laufs nichts belegt.
PräsentationMenüs, Anzeigen, Grafik, Ton
6/10
Aufnahme vorhanden, Kampf-HUD sichtbar.
CodequalitätTests, Struktur, Selbstkorrekturen
4/10
Keine Testdateien, aber auch kein einziges Reparaturskript, anders als beim Moorhuhn-Lauf desselben Modells.
UmfangWie viel vom Auftrag wurde erfüllt?
6/10
26 Dateien, 8 705 Zeilen, davon 24 JavaScript-Dateien im Quellcode. Die 96 Grafik- und Tondateien sind CC0-Material und nicht mitgezählt.
Diese Bewertung ist ein Vorschlag und von Kai Bennett noch nicht bestätigt. Codequalität und Umfang stützen sich auf ausgezählte Dateien, Quell- und Testzeilen sowie Reparaturskripte im Belegrepo.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
Keine Selbstkorrekturen protokolliert.
Nachprüfbar ist das Fehlen selbst: das Belegrepo führt für diesen Lauf unter LAUF.md „Rohprotokoll: keins“, und die Prüfsummenliste evidence/SHA256SUMS enthält sechs Protokolle, keines davon für Qwen3.6 mit Clair Obscure. Gearbeitet wurde zwischen dem 23. und dem 27. Juli 2026.
Bilderkennung
Eigener Testlauf mit demselben Modell auf derselben Maschine, Teil eines anderen Laufs.
Werte ablesen
50 von 50
Dashboard, 50 prüfbare Angaben
Preisschilder
4 von 4
vollständig richtig gelesen
Erfundene Schilder
0
keins als sicher behauptet
Fallen bestanden
4 von 4
Stellen, die vom Muster abweichen
Vorläufig: der Lösungsschlüssel für die Preisschilder ist noch nicht vollständig gesichert.
Aufgabe 1 · Werte ablesen
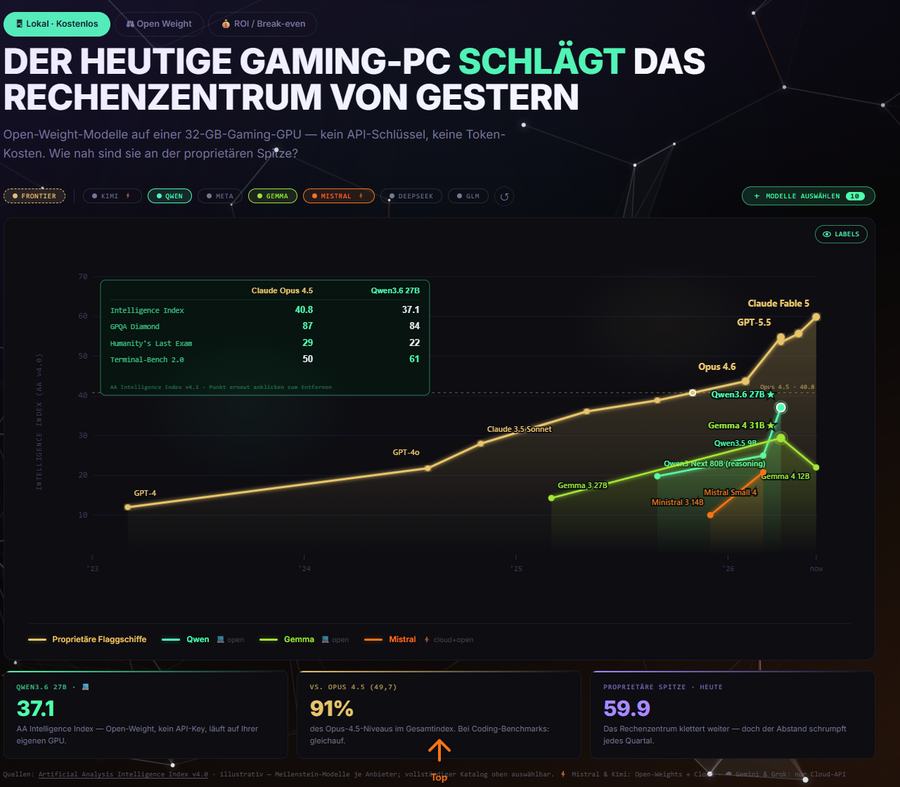
Was das Modell aus der Tooltip-Tabelle gelesen hat
| Claude Opus 4.5 | Qwen3.6 27B | |
|---|---|---|
| Intelligence Index | 40.8 | 37.1 |
| GPQA Diamond | 87 | 84 |
| Humanity's Last Exam | 29 | 22 |
| Terminal-Bench 2.0 | 50 | 61 |
Und aus den Kennzahlkacheln
- QWEN3.6 27B 37.1 · AA Intelligence Index — Open-Weight, kein API-Key, läuft auf Ihrer eigenen GPU.
- VS. OPUS 4.5 (40,7) 91% · des Opus-4.5-Niveaus im Gesamtindex. Bei Coding-Benchmarks: gleichauf.
- PROPRIETÄRE SPITZE · HEUTE 59.9 · Das Rechenzentrum klettert weiter — doch der Abstand schrumpft jedes Quartal.
Aufgabe 2 · Komplexe Schrifterkennung
Geprüft wird das Lesen von winzigen, schräg stehenden, teils verdeckten Schriften in einem Foto mit über vierzig Objekten, dazu zwei Währungszeichen, die sich bei starker Drehung kaum unterscheiden. Zum Test werden die Preisschilder verwendet.
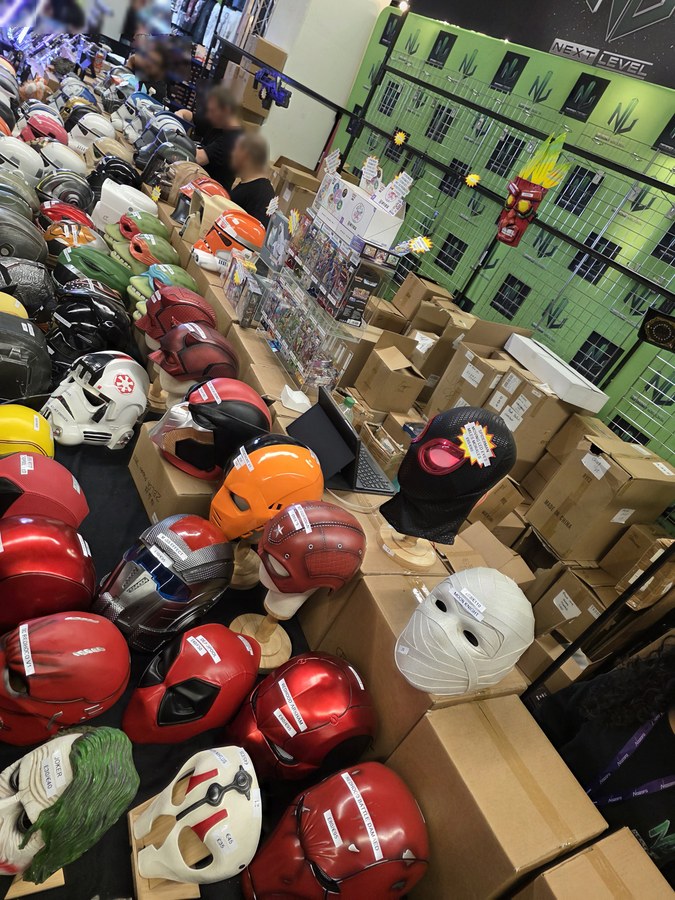
Was das Modell gelesen hat
| Was das Modell dort las | £ | € | Reihenfolge | sicher | |
|---|---|---|---|---|---|
| 1 | JOKER | 30 | 40 | gbp zuerst | ja |
| 2 | REDHOOD ARKHAM | 80 | 65 | gbp zuerst | ja |
| 3 | REDHOOD BATTLE DAMAGED | 80 | 65 | gbp zuerst | ja |
| 4 | ohne Namen | 35 | 45 | eur zuerst | ja |
| 5 | DC REDHOOD V1 | nicht lesbar | nicht lesbar | · | nein |
| 6 | DEADPOOL | nicht lesbar | nicht lesbar | · | nein |
Das Modell zählte 6 Schilder im Wertungsbereich. Der Lösungsschlüssel steht hier bewusst nicht daneben, sonst könnte ein späteres Modell ihn von dieser Seite ablesen.
Das Modell über die schwierigste Stelle: „Die Preisschilder auf Bild B bei starkem Drehwinkel — insbesondere DEADPOOL und DC REDHOOD V1, wo die Währungszeichen £ und € bei der Schräglage nicht sicher unterscheidbar sind. Auch die exakte Position des REDHOOD BATTLE DAMAGED-Schilds relativ zur x=700-Grenze ist unsicher.“
Wo sich das Modell selbst unsicher war (4 Stellen)
- DEADPOOL: Preistag im Winkel, Zahlen und Währungszeichen nicht sicher lesbar
- DC REDHOOD V1: Preistag nicht einsehbar (Nur Name lesbar)
- REDHOOD BATTLE DAMAGED: ob Schild innerhalb x<700 liegt (am Rand des Wertungsbereichs)
- Weiße Maske: ob ein Name auf dem Schild steht (nicht erkennbar, nur €45/£35 lesbar)
Diese Liste hat das Modell selbst geschrieben, nicht der Auswerter. Sie zählt in die Wertung: ein eingestandenes „nicht lesbar“ kostet einen Punkt, eine erfundene Angabe kostet mehr.
Die vollständige Antwort des Modells als JSON · Die Auswertung dazu steht nicht daneben: sie nennt zu jedem Fehler den richtigen Wert, und damit läge der Lösungsschlüssel offen.
Quellen
- Modellgewichtehuggingface.co/unsloth/Qwen3.6-27B-GGUF
- Modellkartehuggingface.co/Qwen/Qwen3.6-27B
- Herstellerseiteqwen.ai
- Messdaten-Repogithub.com/KaiFelixBennett/local-ai-amd-benchmark
- Rohprotokoll dieses Laufsgithub.com/KaiFelixBennett/local-ai-amd-benchmark/blob/main/evidence/logs/qwen36-27b-q6-moorhuhn-r9700.log
- Quelltext · Moorhuhn · UD-Q6_K_XL · Reasoning an, Budget 20000 Tokengithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/qwen36-27b/moorhuhn-q6
- Quelltext · Clair Obscure · UD-Q6_K_XL · Reasoning an, Budget 20000 Tokengithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/qwen36-27b/clairobscure-q6
Selbst ausprobieren
- Gewichte laden · Bezugsquelle
- llama-server mit der Startzeile oben starten
- Den Endpunkt in VS Code als eigenes Modell eintragen und den Agenten wählen
Auftrag, Agentdateien und Werkzeuge: Agent Test Harness
Zitieren: Kai Felix Bennett, „Nutzbarkeitstest von lokaler KI auf AMD-Hardware", benchmark.securesight.ai, Lauf qwen36-27b-q6-moorhuhn-r9700. Messdaten CC-BY-4.0.
Messdaten CC-BY-4.0, Code MIT.