Lokal gelaufen
Qwen3.8-27B
Radeon AI PRO R9700 · 3 Läufe
- Hardware
- Radeon AI PRO R9700gfx1201 · RDNA4
- Speicher
- 32 GB dediziert
- Aufgaben
- Moorhuhn, Clair Obscure, Bilderkennung
- Quantisierungen
- UD-Q4_K_XL, UD-Q6_K_M
Persönliche Meinung
Kai Bennett
Es ist für mich das erste Modell, das ich auf meiner Hardware auch ernsthaft für Coding einsetzen würde. Klar, der Vorgänger, das Qwen 3.6 27b, war auch schon stark, aber aus meiner Sicht wurde hier nochmal in Sachen Qualität, agentischem Coding und der Fähigkeit die eigenen Ergebnisse zu reviewen, eine ordentliche Schippe draufgelegt. Für Setups zwischen 24 und 128 GB VRAM ist das für mich im September 2026 das beste Modell.
Spannend finde ich, dass es nun auch unzensierte Varianten davon gibt, bei denen die Guardrails komplett deaktiviert sind, das hat natürlich Vor- und Nachteile zugleich.
Beschreibung des Modells
Dichtes Modell mit 27 Milliarden Parametern und 262 144 Token nativem Kontext, laut Modellkarte erweiterbar auf 1 000 000 Token. Die Karte nennt 64 Schichten mit dem Aufbau 16 × (3 × (Gated DeltaNet → FFN) → 1 × (Gated Attention → FFN)), die config.json setzt full_attention_interval auf 4. Als Typ gibt die Karte ein kausales Sprachmodell mit Vision-Encoder an, für den die config.json 27 Schichten angibt (Feld vision_config.depth). Die Karte nennt außerdem Multi-Token-Prediction im Training, die Lizenz ist Apache 2.0.
- Architektur
- Dicht (Modellkarte: „dense model“)
- Parameter
- 27B
- Schichten
- 64
- Schichtaufbau
- 16 × (3 × (Gated DeltaNet → FFN) → 1 × (Gated Attention → FFN))
- Kontext nativ
- 262 144 Token
- Kontext erweiterbar
- bis 1 000 000 Token
- Lizenz
- Apache 2.0
Angaben des Herstellers: Quelle · Modellkarte · Hersteller
Lauf: Moorhuhn · UD-Q4_K_XL · Reasoning xhigh · 31. August 2026
Die Zahlen auf einen Blick
Decode, Median
33,69 t/s
82 gewertete Antworten
Decode, p10 bis p90
27,83–45,34 t/s
Antworten ab 200 Tokens werden gewertet; kürzere erzeugen im Protokoll Ausreißer bis über 1 000 000 t/s, weil dort ein einzelnes Token in nahezu null Millisekunden fällt. Median klassisch, Perzentile nach Rangplatz. Beim Prefill gilt diese Schwelle NICHT, dort zählt jede Auswertung.
Spitze
84,92 t/s
einzelne Antwort
Prefill, Median
234,9 t/s
Ausgabe erzeugt
332.405 Token
nur die gewerteten Antworten ab 200 Tokens
Laufzeit
9,0 h
540 Minuten
Selbstkorrekturen
4
Antworten gesamt
108
82 davon gewertet
Eingabe gesamt
8,04 Mio. Token
Kontext aller 108 Anfragen zusammengezählt
davon neu berechnet
503.681 Token
7,54 Mio. lagen im Prompt-Cache
Durch das Modell gelaufen
8,38 Mio. Token
Eingabe und Ausgabe zusammen
Bei einem Anbieter
1,24 USD
Qwen3.8-27B gehostet, günstigster Tarif
Was dieser Lauf gekostet hätte, wenn Qwen3.8-27B bei einem Anbieter gelaufen wäre
| Anbieter | Eingabeje Mio. | Ausgabeje Mio. | Cacheje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|
| Darkbloom | 0,15 | 2,00 | · | 1,88 | · |
| Parasail | 0,24 | 2,20 | 0,050 | 2,67 | 1,24 |
| Chutes | 0,32 | 2,50 | 0,032 | 3,41 | 1,24 |
| Alibaba Cloud | 0,42 | 2,55 | 0,085 | 4,28 | 1,71 |
Alle Beträge in USD. Die ersten drei Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit denselben Token wie links: 8 043 931 Eingabe über alle Anfragen, davon 503 681 neu berechnet und 7 540 250 aus dem Prompt-Cache, dazu 336 107 Ausgabe. Die Spalte „ohne Cache“ setzt die ganze Eingabe zum Eingabetarif an, die Spalte „mit Cache“ rechnet den zwischengespeicherten Teil zum Cache-Tarif des Anbieters. Anbieter mit Cache-Tarif sind der Regelfall, deshalb ist die rechte Spalte die realistischere. Es sind die Preise für Qwen3.8-27B selbst, bei Anbietern die genau dieses Modell hosten, nicht die eines fremden Cloud-Modells. Stand 07.09.2026, Listenpreise ohne Mengenrabatt. Lokal kostet der Lauf statt dessen Strom und die Anschaffung der Karte. Preise bei OpenRouter, abgerufen am 2026-09-07.
Was dieser Lauf gekostet hätte, wenn Sonnet 5 mit gleichem Tokenverbrauch gelaufen wäre
| Modell | Eingabeje Mio. | Ausgabeje Mio. | Cache schreibenje Mio. | Cache lesenje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|---|
| Sonnet 5 | 2,00 | 10,00 | 2,50 | 0,20 | 19,45 | 6,13 |
Alle Beträge in USD. Die ersten vier Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit genau den Token dieses Laufs: 8 043 931 Eingabe, davon 503 681 neu und 7 540 250 aus dem Cache, dazu 336 107 Ausgabe. Ohne Cache zum Eingabetarif, mit Cache zahlt der neue Teil den Schreibtarif und der zwischengespeicherte den Lesetarif. Das ist ein Vergleich unter der Annahme gleichen Tokenverbrauchs. Ein anderes Modell löst dieselbe Aufgabe mit anderer Tokenzahl, meist mit weniger; die Zeile sagt also, was diese Token bei Sonnet 5 gekostet hätten, nicht was Sonnet 5 für diese Aufgabe gekostet hätte. Preisliste von Anthropic, abgerufen am 2026-09-08.
Thinking Token: Sie stecken in den Ausgabetoken, lassen sich aber nicht herausrechnen. llama.cpp weist beim Start selbst darauf hin: „chat template supports preserving reasoning, consider enabling it via --reasoning-preserve“. Die Option war nicht gesetzt, deshalb trennt das Protokoll Denken und Antwort nicht.
llama.cpp-Serverlog · 82 Antworten ab 200 Tokens. Laufzeit rund 9 h in zwei Sitzungen (31.08. ab 15:58, 01.09. bis 09:50), am Ende manuell gestoppt. Das Protokoll deckt nur die erste Sitzung ab (3,2 h); danach lief der Server neu. · Rohprotokoll
Ergebnisse
Moorland Mayhem — Featherstorm
Öffnet in einer eigenen EbeneZielen und schießen mit Maus oder Finger, R lädt nach. Der Start liegt hinter Modus- und Kartenauswahl, nicht direkt hinter dem ersten Knopf. Braucht WebGL. Der erste Klick nach dem Laden wird verschluckt, der zweite wirkt.
Eingriff der Website: Der Build liest localStorage ohne Absicherung. Im Sandkasten wirft das, und der Ladebildschirm bliebe stehen. Die eingebettete Fassung bekommt deshalb einen Ersatzspeicher, der nur im Arbeitsspeicher lebt; ein Spielstand überlebt kein Neuladen. Das Original im Repo ist unverändert.
Lädt erst auf Klick · 0,3 MB Übertragung · 1,3 MB entpackt
Prefill über Kontexttiefe
Ein Spitzenwert bei kurzem Kontext sagt wenig darüber, wie sich ein Modell nach Stunden anfühlt.
Kontexttiefe in tausend Token · Median je 30K-Band aus dem Serverlog. Gewertet werden nur Auswertungen ab 1 000 Token, weil die Rate sonst am Aufruf-Overhead hängt statt an der Tiefe: unter 300 Token liegt der Median bei 158 t/s, ab 5 000 Token bei 333. Der Kontextstand stammt aus pos_max, nicht aus der Zahl der ausgewerteten Token, denn unter Prompt-Caching zählt „prompt eval time“ nur das Neue. 7 bis 17 Messungen je Band, tiefster erreichter Stand 140 016 Token. Unter 20K gibt es keine Messung, so lang ist schon der Auftrag.
llama.cpp Startparameter
- Kontext
- 262.144
- KV-Cache
- q8_0 / q8_0
- Micro-Batch
- 288
- Spekulativ
- draft-mtp + ngram-mod 24/48/64 · n_max 2
- Build
- b10717
llama-server -m Qwen3.8-27B-UD-Q4_K_XL.gguf ^
  --load-mode none --mmproj mmproj-F16.gguf --image-min-tokens 1024 ^
  --alias Qwen3.8-27B -dev Vulkan0 --host 127.0.0.1 --port 8080 ^
  -c 262144 -ngl 99 -fa on --fit off -ot "token_embd\.weight=Vulkan0" ^
  -ctk q8_0 -ctv q8_0 -b 2048 -ub 288 ^
  --parallel 1 --kv-unified ^
  --ctx-checkpoints 4 --checkpoint-min-step 16384 --cache-ram 0 ^
  --spec-type draft-mtp,ngram-mod --spec-draft-n-max 2 ^
  --spec-ngram-mod-n-match 24 --spec-ngram-mod-n-min 48 --spec-ngram-mod-n-max 64 ^
  --spec-draft-device Vulkan0 --spec-draft-ngl 99 ^
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 ^
  --presence-penalty 0.0 --repeat-penalty 1.0 ^
  --jinja --reasoning on --reasoning-effort xhigh --reasoning-format deepseek --reasoning-budget -1
Einordnung
31 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
7/10
Es gibt ein gutes Spielgefühl im Moorhuhn Test und ist abwechslungreich, ich hab tatsächlich auch Spaß beim spielen auch wenn es ein paar kleinere Fehler gibt.
PräsentationMenüs, Anzeigen, Grafik, Ton
7/10
Hauptmenü mit elf Einträgen, HUD, Fortschrittsmenü, die Anleitung ist etwas bedürftig, auch muss ich 2x auf Starten klicken damit es losgeht, es sind noch kleinere Bugs vorhanden, insgesamt aber schon beeindruckend für einen Single Shot.
CodequalitätTests, Struktur, Selbstkorrekturen
8/10
11 Testdateien mit 1 257 Testzeilen, keine Reparaturskripte. Vorgegebene Struktur wurde umgesetzt.
UmfangWie viel vom Auftrag wurde erfüllt?
9/10
42 Dateien, 10 838 Zeilen; Spielmodi, Menüs und Statistiken vollständig.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
Es gab vier Selbstkorrekturen des Modells.
llama.cpp-Serverlog · 82 Antworten ab 200 Tokens. Laufzeit rund 9 h in zwei Sitzungen (31.08. ab 15:58, 01.09. bis 09:50), am Ende manuell gestoppt. Das Protokoll deckt nur die erste Sitzung ab (3,2 h); danach lief der Server neu.
Lauf: Moorhuhn · UD-Q4_K_XL · Reasoning medium · 01. September 2026
Die Zahlen auf einen Blick
Kein Serverprotokoll, deshalb keine Geschwindigkeit. Der Ablauf stammt aus dem Chatverlauf und dem ausgelieferten Quelltext, die Laufzeit aus der Anzeige in VS Code.
Laufzeit
6,5 h
388 Minuten
Selbstkorrekturen
2
Zweiter Durchgang desselben Modells mit derselben Startzeile, nur mit --reasoning-effort medium statt xhigh. Laufzeit 6 h 28 min, von Kai Bennett aus der Anzeige in VS Code abgelesen. Ein Auftrag und ein Klick auf „Continue to iterate“, sonst kein Eingriff. Der Chatverlauf zählt 95 Terminalbefehle, 110 abgeschlossene Werkzeugaufrufe und 17 Test-, Build- oder Lint-Läufe. Eine Decode-Geschwindigkeit gibt es nicht: dafür bräuchte es das Serverprotokoll, und das liegt für diesen Lauf nicht vor.
Ergebnisse
Moorland Mayhem — Featherstorm
Öffnet in einer eigenen EbeneZielen und schießen mit Maus oder Finger. Braucht WebGL.
Lädt erst auf Klick · — MB Übertragung · — MB entpackt
llama.cpp Startparameter
- Kontext
- 262.144
- KV-Cache
- q8_0 / q8_0
- Micro-Batch
- 288
- Spekulativ
- draft-mtp + ngram-mod 24/48/64 · n_max 2
- Build
- b10717
llama-server -m Qwen3.8-27B-UD-Q4_K_XL.gguf ^
  --load-mode none --mmproj mmproj-F16.gguf --image-min-tokens 1024 ^
  --alias Qwen3.8-27B -dev Vulkan0 --host 127.0.0.1 --port 8080 ^
  -c 262144 -ngl 99 -fa on --fit off -ot "token_embd\.weight=Vulkan0" ^
  -ctk q8_0 -ctv q8_0 -b 2048 -ub 288 ^
  --parallel 1 --kv-unified ^
  --ctx-checkpoints 4 --checkpoint-min-step 16384 --cache-ram 0 ^
  --spec-type draft-mtp,ngram-mod --spec-draft-n-max 2 ^
  --spec-ngram-mod-n-match 24 --spec-ngram-mod-n-min 48 --spec-ngram-mod-n-max 64 ^
  --spec-draft-device Vulkan0 --spec-draft-ngl 99 ^
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 ^
  --presence-penalty 0.0 --repeat-penalty 1.0 ^
  --jinja --reasoning on --reasoning-effort medium --reasoning-format deepseek --reasoning-budget -1
Einordnung
26 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
6/10
Startet und ist spielbar, aber das Hauptmenü trägt fünf statt elf Einträge.
PräsentationMenüs, Anzeigen, Grafik, Ton
6/10
Keine Aufnahme vorhanden, beurteilt am ausgelieferten Build.
CodequalitätTests, Struktur, Selbstkorrekturen
8/10
10 Testdateien mit 604 Testzeilen, kein Reparaturskript.
UmfangWie viel vom Auftrag wurde erfüllt?
6/10
44 Dateien, 8 530 Zeilen; gegenüber dem xhigh-Lauf fehlen Modi.
Diese Bewertung ist ein Vorschlag und von Kai Bennett noch nicht bestätigt. Codequalität und Umfang stützen sich auf ausgezählte Dateien, Quell- und Testzeilen sowie Reparaturskripte im Belegrepo.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
Es gab zwei Selbstkorrekturen des Modells.
Zweiter Durchgang desselben Modells mit derselben Startzeile, nur mit --reasoning-effort medium statt xhigh. Laufzeit 6 h 28 min, von Kai Bennett aus der Anzeige in VS Code abgelesen. Ein Auftrag und ein Klick auf „Continue to iterate“, sonst kein Eingriff. Der Chatverlauf zählt 95 Terminalbefehle, 110 abgeschlossene Werkzeugaufrufe und 17 Test-, Build- oder Lint-Läufe. Eine Decode-Geschwindigkeit gibt es nicht: dafür bräuchte es das Serverprotokoll, und das liegt für diesen Lauf nicht vor.
Lauf: Clair Obscure · UD-Q6_K_M · Reasoning an, ohne Begrenzung · 24. August 2026
Die Zahlen auf einen Blick
Decode, Median
26,30 t/s
30 gewertete Antworten
Decode, p10 bis p90
15,55–34,22 t/s
Antworten ab 200 Tokens werden gewertet; kürzere erzeugen im Protokoll Ausreißer bis über 1 000 000 t/s, weil dort ein einzelnes Token in nahezu null Millisekunden fällt. Median klassisch, Perzentile nach Rangplatz. Beim Prefill gilt diese Schwelle NICHT, dort zählt jede Auswertung.
Spitze
42,39 t/s
einzelne Antwort
Prefill, Median
159,4 t/s
Ausgabe erzeugt
118.919 Token
nur die gewerteten Antworten ab 200 Tokens
Laufzeit
1,9 h
115 Minuten
Selbstkorrekturen
6
Antworten gesamt
35
30 davon gewertet
Eingabe gesamt
3,24 Mio. Token
Kontext aller 35 Anfragen zusammengezählt
davon neu berechnet
293.109 Token
2,95 Mio. lagen im Prompt-Cache
Durch das Modell gelaufen
3,36 Mio. Token
Eingabe und Ausgabe zusammen
Bei einem Anbieter
0,48 USD
Qwen3.8-27B gehostet, günstigster Tarif
Was dieser Lauf gekostet hätte, wenn Qwen3.8-27B bei einem Anbieter gelaufen wäre
| Anbieter | Eingabeje Mio. | Ausgabeje Mio. | Cacheje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|
| Darkbloom | 0,15 | 2,00 | · | 0,73 | · |
| Parasail | 0,24 | 2,20 | 0,050 | 1,04 | 0,48 |
| Chutes | 0,32 | 2,50 | 0,032 | 1,34 | 0,49 |
| Alibaba Cloud | 0,42 | 2,55 | 0,085 | 1,68 | 0,68 |
Alle Beträge in USD. Die ersten drei Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit denselben Token wie links: 3 240 306 Eingabe über alle Anfragen, davon 293 109 neu berechnet und 2 947 197 aus dem Prompt-Cache, dazu 119 627 Ausgabe. Die Spalte „ohne Cache“ setzt die ganze Eingabe zum Eingabetarif an, die Spalte „mit Cache“ rechnet den zwischengespeicherten Teil zum Cache-Tarif des Anbieters. Anbieter mit Cache-Tarif sind der Regelfall, deshalb ist die rechte Spalte die realistischere. Es sind die Preise für Qwen3.8-27B selbst, bei Anbietern die genau dieses Modell hosten, nicht die eines fremden Cloud-Modells. Stand 07.09.2026, Listenpreise ohne Mengenrabatt. Lokal kostet der Lauf statt dessen Strom und die Anschaffung der Karte. Preise bei OpenRouter, abgerufen am 2026-09-07.
Was dieser Lauf gekostet hätte, wenn Sonnet 5 mit gleichem Tokenverbrauch gelaufen wäre
| Modell | Eingabeje Mio. | Ausgabeje Mio. | Cache schreibenje Mio. | Cache lesenje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|---|
| Sonnet 5 | 2,00 | 10,00 | 2,50 | 0,20 | 7,68 | 2,52 |
Alle Beträge in USD. Die ersten vier Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit genau den Token dieses Laufs: 3 240 306 Eingabe, davon 293 109 neu und 2 947 197 aus dem Cache, dazu 119 627 Ausgabe. Ohne Cache zum Eingabetarif, mit Cache zahlt der neue Teil den Schreibtarif und der zwischengespeicherte den Lesetarif. Das ist ein Vergleich unter der Annahme gleichen Tokenverbrauchs. Ein anderes Modell löst dieselbe Aufgabe mit anderer Tokenzahl, meist mit weniger; die Zeile sagt also, was diese Token bei Sonnet 5 gekostet hätten, nicht was Sonnet 5 für diese Aufgabe gekostet hätte. Preisliste von Anthropic, abgerufen am 2026-09-08.
llama.cpp-Serverlog · 30 von 35 Antworten ab 200 Tokens · Lauf vom 28.08.2026. Der Server lief 115,8 Minuten am Stück. Von der ersten Aufgabe bis zum Ende der letzten sind es 114,9 Minuten, ohne eine einzige Pause über 60 Sekunden dazwischen. Die reine Rechenzeit auf der GPU beträgt davon 114,5 Minuten, davon 88,8 Minuten Erzeugung. · Rohprotokoll
Ergebnisse
Clair Obscure — Expedition 33 (Reactive Combat Study)
Öffnet in einer eigenen EbeneMaus und Tastatur. Angriffe des Gegners werden angekündigt, Parieren und Ausweichen laufen in Echtzeit. Braucht WebGL.
Lädt erst auf Klick · 0,4 MB Übertragung · 1,9 MB entpackt
Prefill über Kontexttiefe
Ein Spitzenwert bei kurzem Kontext sagt wenig darüber, wie sich ein Modell nach Stunden anfühlt.
Kontexttiefe in tausend Token · Momentanrate innerhalb eines einzigen durchgehenden Prefills: Task 0 dieses Laufs verarbeitete 180 396 Token am Stück. llama.cpp meldet dabei alle 2 048 Token einen Zwischenstand; die Rate ist der Quotient aus Token und Zeit zwischen zwei aufeinanderfolgenden Ständen. 92 Stützstellen liegen vor, gezeigt sind sieben davon. Weil alle aus demselben Prefill stammen, ist die Kurve frei von Unterschieden zwischen Anfragen. Von 8 K auf 164 K fällt die Rate um den Faktor 4,2. Jeder Punkt ist aus dem verlinkten Serverprotokoll nachrechenbar.
llama.cpp Startparameter
- Kontext
- 262.144
- KV-Cache
- q8_0 / turbo4
- Micro-Batch
- 128
- Spekulativ
- draft-mtp + ngram-mod · Annahme 0,553
- Build
- bd9bd1b
llama-server -m Qwen3.8-27B-UD-Q6_K_M.gguf ^
  --load-mode none --mmproj mmproj-F16.gguf --image-min-tokens 1024 ^
  -dev Vulkan0 --host 127.0.0.1 --port 8080 ^
  -c 262144 -ngl 99 -fa on --fit off -ot "token_embd\.weight=Vulkan0" ^
  -ctk q8_0 -ctv turbo4 -b 2048 -ub 128 ^
  --parallel 1 --kv-unified ^
  --ctx-checkpoints 4 --checkpoint-min-step 16384 --cache-ram 0 ^
  --spec-type draft-mtp,ngram-mod --spec-draft-n-max 2 ^
  --spec-ngram-mod-n-match 24 --spec-ngram-mod-n-min 48 --spec-ngram-mod-n-max 64 ^
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 ^
  --jinja --reasoning on --reasoning-format deepseek --reasoning-budget -1
Einordnung
28 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
8/10
Im Browser spielbar; Angriffe werden angekündigt, Parieren und Ausweichen laufen in Echtzeit.
PräsentationMenüs, Anzeigen, Grafik, Ton
8/10
Aufnahme vorhanden, Kampf-HUD vollständig.
CodequalitätTests, Struktur, Selbstkorrekturen
4/10
Keine Testdateien; sechs protokollierte Selbstkorrekturen.
UmfangWie viel vom Auftrag wurde erfüllt?
8/10
36 Dateien, 11 115 Zeilen, der umfangreichste Clair-Obscure-Lauf auf lokaler Hardware.
Diese Bewertung ist ein Vorschlag und von Kai Bennett noch nicht bestätigt. Codequalität und Umfang stützen sich auf ausgezählte Dateien, Quell- und Testzeilen sowie Reparaturskripte im Belegrepo.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
Es gab sechs Selbstkorrekturen des Modells.
llama.cpp-Serverlog · 30 von 35 Antworten ab 200 Tokens · Lauf vom 28.08.2026. Der Server lief 115,8 Minuten am Stück. Von der ersten Aufgabe bis zum Ende der letzten sind es 114,9 Minuten, ohne eine einzige Pause über 60 Sekunden dazwischen. Die reine Rechenzeit auf der GPU beträgt davon 114,5 Minuten, davon 88,8 Minuten Erzeugung.
Bilderkennung
Eigener Testlauf mit demselben Modell auf derselben Maschine, Teil eines anderen Laufs. Die Zeit ist aus der VS Code Chatanzeige notiert.
Werte ablesen
44 von 50
Dashboard, 50 prüfbare Angaben
Preisschilder
2 von 4
vollständig richtig gelesen
Erfundene Schilder
4
1 davon als sicher behauptet
Fallen bestanden
2 von 4
Stellen, die vom Muster abweichen
Vorläufig: der Lösungsschlüssel für die Preisschilder ist noch nicht vollständig gesichert.
Aufgabe 1 · Werte ablesen
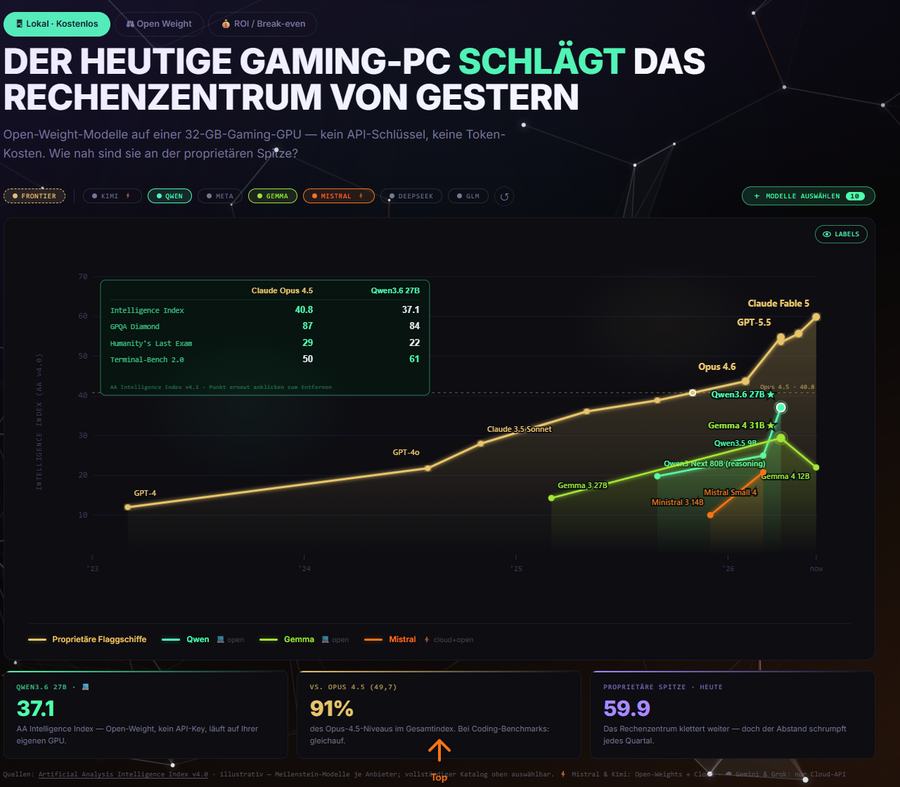
Was das Modell aus der Tooltip-Tabelle gelesen hat
| Claude Opus 4.5 | Qwen3.6 27B | |
|---|---|---|
| Intelligence Index | 40.8 | 37.1 |
| GPQA Diamond | 87 | 84 |
| Humanity's Last Exam | 29 | 22 |
| Terminal-Bench 2.0 | 50 | 61 |
Und aus den Kennzahlkacheln
- QWEN3.6 27B · OPEN 37.1 · AA Intelligence Index — Open-Weight, kein API-Key, läuft auf ihrer eigenen GPU.
- VS. OPUS 4.5 (40,7) 91% · des Opus-4.5-Niveaus im Gesamtindex. Bei Coding-Benchmarks: gleichauf.
- PROPRIETÄRE SPIEZE · HEUTE 59.9 · Das Rechenzentrum klettert weiter — doch der Abstand schrumpft jedes Quartal.
Aufgabe 2 · Komplexe Schrifterkennung
Geprüft wird das Lesen von winzigen, schräg stehenden, teils verdeckten Schriften in einem Foto mit über vierzig Objekten, dazu zwei Währungszeichen, die sich bei starker Drehung kaum unterscheiden. Zum Test werden die Preisschilder verwendet.
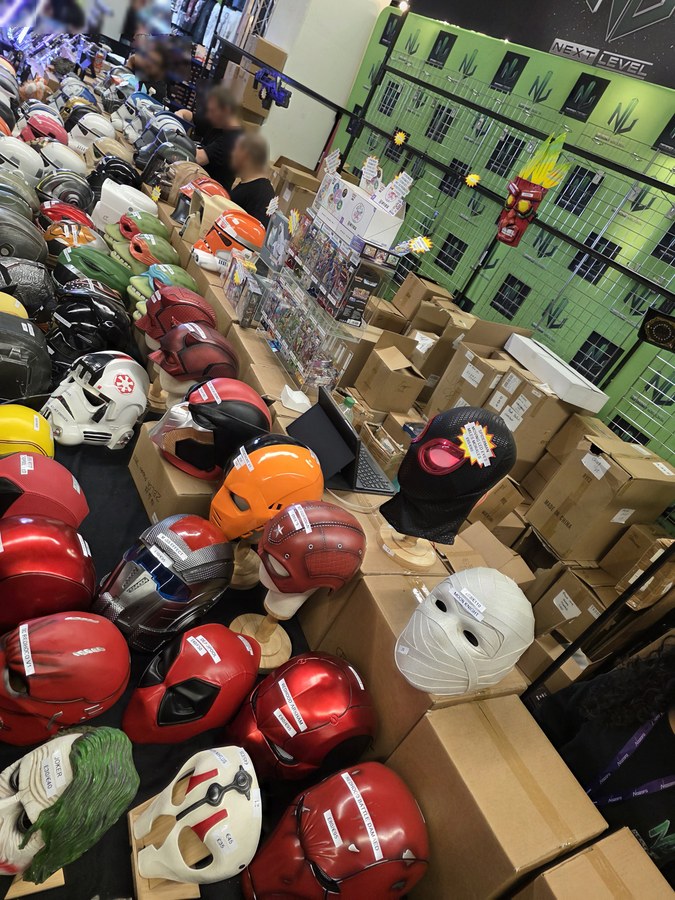
Was das Modell gelesen hat
| Was das Modell dort las | £ | € | Reihenfolge | sicher | |
|---|---|---|---|---|---|
| 1 | REDHOOD ARKHAM | 80 | 65 | gbp zuerst | ja |
| 2 | JOKER | 50 | 40 | gbp zuerst | nein |
| 3 | ohne Namen | 45 | 35 | gbp zuerst | ja |
| 4 | REDHOOD (BATTL) DARK RED | 80 | 65 | gbp zuerst | nein |
| 5 | BANE | nicht lesbar | nicht lesbar | · | nein |
| 6 | HULK | nicht lesbar | nicht lesbar | · | nein |
| 7 | BATMAN | nicht lesbar | nicht lesbar | · | nein |
Das Modell zählte 7 Schilder im Wertungsbereich. Der Lösungsschlüssel steht hier bewusst nicht daneben, sonst könnte ein späteres Modell ihn von dieser Seite ablesen.
Das Modell über die schwierigste Stelle: „Der dicht beieinander liegende Datenpunkt-Cluster im rechten Diagrammbereich (Qwen/Gemma/Mistral-Labels überlappen) und die kleinen Währungssymbole auf den schräg stehenden Preisschildern in Bild B (€ vs. £ kaum unterscheidbar).“
Wo sich das Modell selbst unsicher war (9 Stellen)
- Bild A: zweiter X-Achsen-Tick — ich lese '24', nicht ausschließen, dass es '23 ist
- Bild A: Y-Achsenlabel hinter 'INTELLIGENZ-INDEX (…)' nicht vollständig lesbar
- Bild A: Kachel 2, Klammerwert liest sich wie '(40,7)', passt aber nicht zu '40.8' im Tooltip — möglicher Lesefehler
- Bild A: Fußzeile des Tooltips nur teilweise lesbar
- Bild A: grauer Legendeneintrag rechts ('Claude+open'?) unscharf
- Bild B: JOKER-Schild — zweites Währungssymbol (£ oder €?)
- Bild B: REDHOOD (BATTL) DARK RED — zweites Währungssymbol unsicher
- Bild B: Namen BANE, HULK, BATMAN sind Vermutungen; dazugehörige Preise nicht lesbar (null statt Raten)
- Bild B: ob das rote Klebeschild am orangefarbenen Helm (ca. y 890–955) noch in den Wertungsbereich fällt, war grenzwertig
Diese Liste hat das Modell selbst geschrieben, nicht der Auswerter. Sie zählt in die Wertung: ein eingestandenes „nicht lesbar“ kostet einen Punkt, eine erfundene Angabe kostet mehr.
Die vollständige Antwort des Modells als JSON · Die Auswertung dazu steht nicht daneben: sie nennt zu jedem Fehler den richtigen Wert, und damit läge der Lösungsschlüssel offen.
Quellen
- Modellgewichtehuggingface.co/unsloth/Qwen3.8-27B-GGUF
- Modellkartehuggingface.co/Qwen/Qwen3.8-27B
- Herstellerseiteqwen.ai
- Messdaten-Repogithub.com/KaiFelixBennett/local-ai-amd-benchmark
- Rohprotokoll dieses Laufsgithub.com/KaiFelixBennett/local-ai-amd-benchmark/blob/main/evidence/logs/qwen38-27b-q4xl-moorhuhn-r9700.log
- Quelltext · Moorhuhn · UD-Q4_K_XL · Reasoning xhighgithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/qwen38-27b/moorhuhn-q4xl-xhigh
- Quelltext · Moorhuhn · UD-Q4_K_XL · Reasoning mediumgithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/qwen38-27b/moorhuhn-q4xl-medium
- Quelltext · Clair Obscure · UD-Q6_K_M · Reasoning an, ohne Begrenzunggithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/qwen38-27b/clairobscure-q6
Selbst ausprobieren
- Gewichte laden · Bezugsquelle
- llama-server mit der Startzeile oben starten
- Den Endpunkt in VS Code als eigenes Modell eintragen und den Agenten wählen
Auftrag, Agentdateien und Werkzeuge: Agent Test Harness
Zitieren: Kai Felix Bennett, „Nutzbarkeitstest von lokaler KI auf AMD-Hardware", benchmark.securesight.ai, Lauf qwen38-27b-q4xl-moorhuhn-r9700. Messdaten CC-BY-4.0.
Messdaten CC-BY-4.0, Code MIT.