Lokal gelaufen
Qwen3.8-Flash-Next
AMD AI MAX 395 (AMD Halo) · GMKtec EVO-X2 · 3 Läufe
- Hardware
- AMD AI MAX 395 (AMD Halo) · GMKtec EVO-X2Strix Halo · Radeon 8060S · gfx1151
- Speicher
- 128 GiB unified
- Aufgaben
- Moorhuhn, Clair Obscure, Bilderkennung
- Quantisierungen
- UD-Q4_K_XL, W4B
Persönliche Meinung
Kai Bennett
Bisher hatte ich noch kein Modell gefunden, das auf dem AMD Strix Halo so richtig gut funktioniert, weil entweder waren es dichte Modelle die mit der niedrigen Bandbreite zu langsam liefen, oder aber sie waren so klein, dass sie auch auf Hardware mit deutlich weniger Speicher gut liefen, oder sie hatten z.B. keine Bilderkennungs - Fähigkeiten.
Dieses Modell ändert das, in den Benchmarks kann es mit viel größeren Modellen mithalten und wird bei artificialanalysis.ai sogar oberhalb von GPT 5.6 Luna (max) eingeordnet, es läuft konstant auch bei größerem Kontext mit um die 20 Token, bzw mit Halogen sogar um die 40 Token pro Sekunde, hat Vision Fähigkeiten, nutzt den vollen Speicher des Geräts und liefert gute Ergebnisse.
Das Modell ist aus meiner Sicht wie gemacht für den AMD Strix Halo oder DGX Spark.
Beschreibung des Modells
Hybrides MoE-Modell mit 125 Milliarden Parametern im Sprachmodell, davon 6 Milliarden je Token aktiv, dazu 51 Milliarden Parameter N-Gramm-Embedding und 4 Milliarden MTP. Die Modellkarte nennt 48 Schichten im Muster 12 × (3 × (Gated DeltaNet → MoE) → 1 × (Qwen Sparse Attention → MoE)) sowie 512 Experten, von denen je Token 10 geroutete und 1 geteilter aktiv sind. Der native Kontext liegt bei 262 144 Token und ist auf 1 000 000 Token erweiterbar. Als Typ ist "Causal Language Model with Vision Encoder" angegeben, die config.json enthält einen Vision-Encoder mit 27 Schichten und Hidden-Größe 1152.
- Gesamtparameter Sprachmodell
- 125B
- Aktive Parameter je Token
- 6B
- N-Gramm-Embedding
- 51B
- MTP
- 4B, 1 Schicht
- Schichten
- 48
- Schichtmuster
- 12 × (3 × (Gated DeltaNet → MoE) → 1 × (Qwen Sparse Attention → MoE))
- Experten
- 512
- Aktive Experten
- 10 geroutet + 1 geteilt
- Kontextlänge
- 262 144 nativ, erweiterbar auf 1 000 000 Token
- Lizenz
- other, license_name qwen-community-1.0
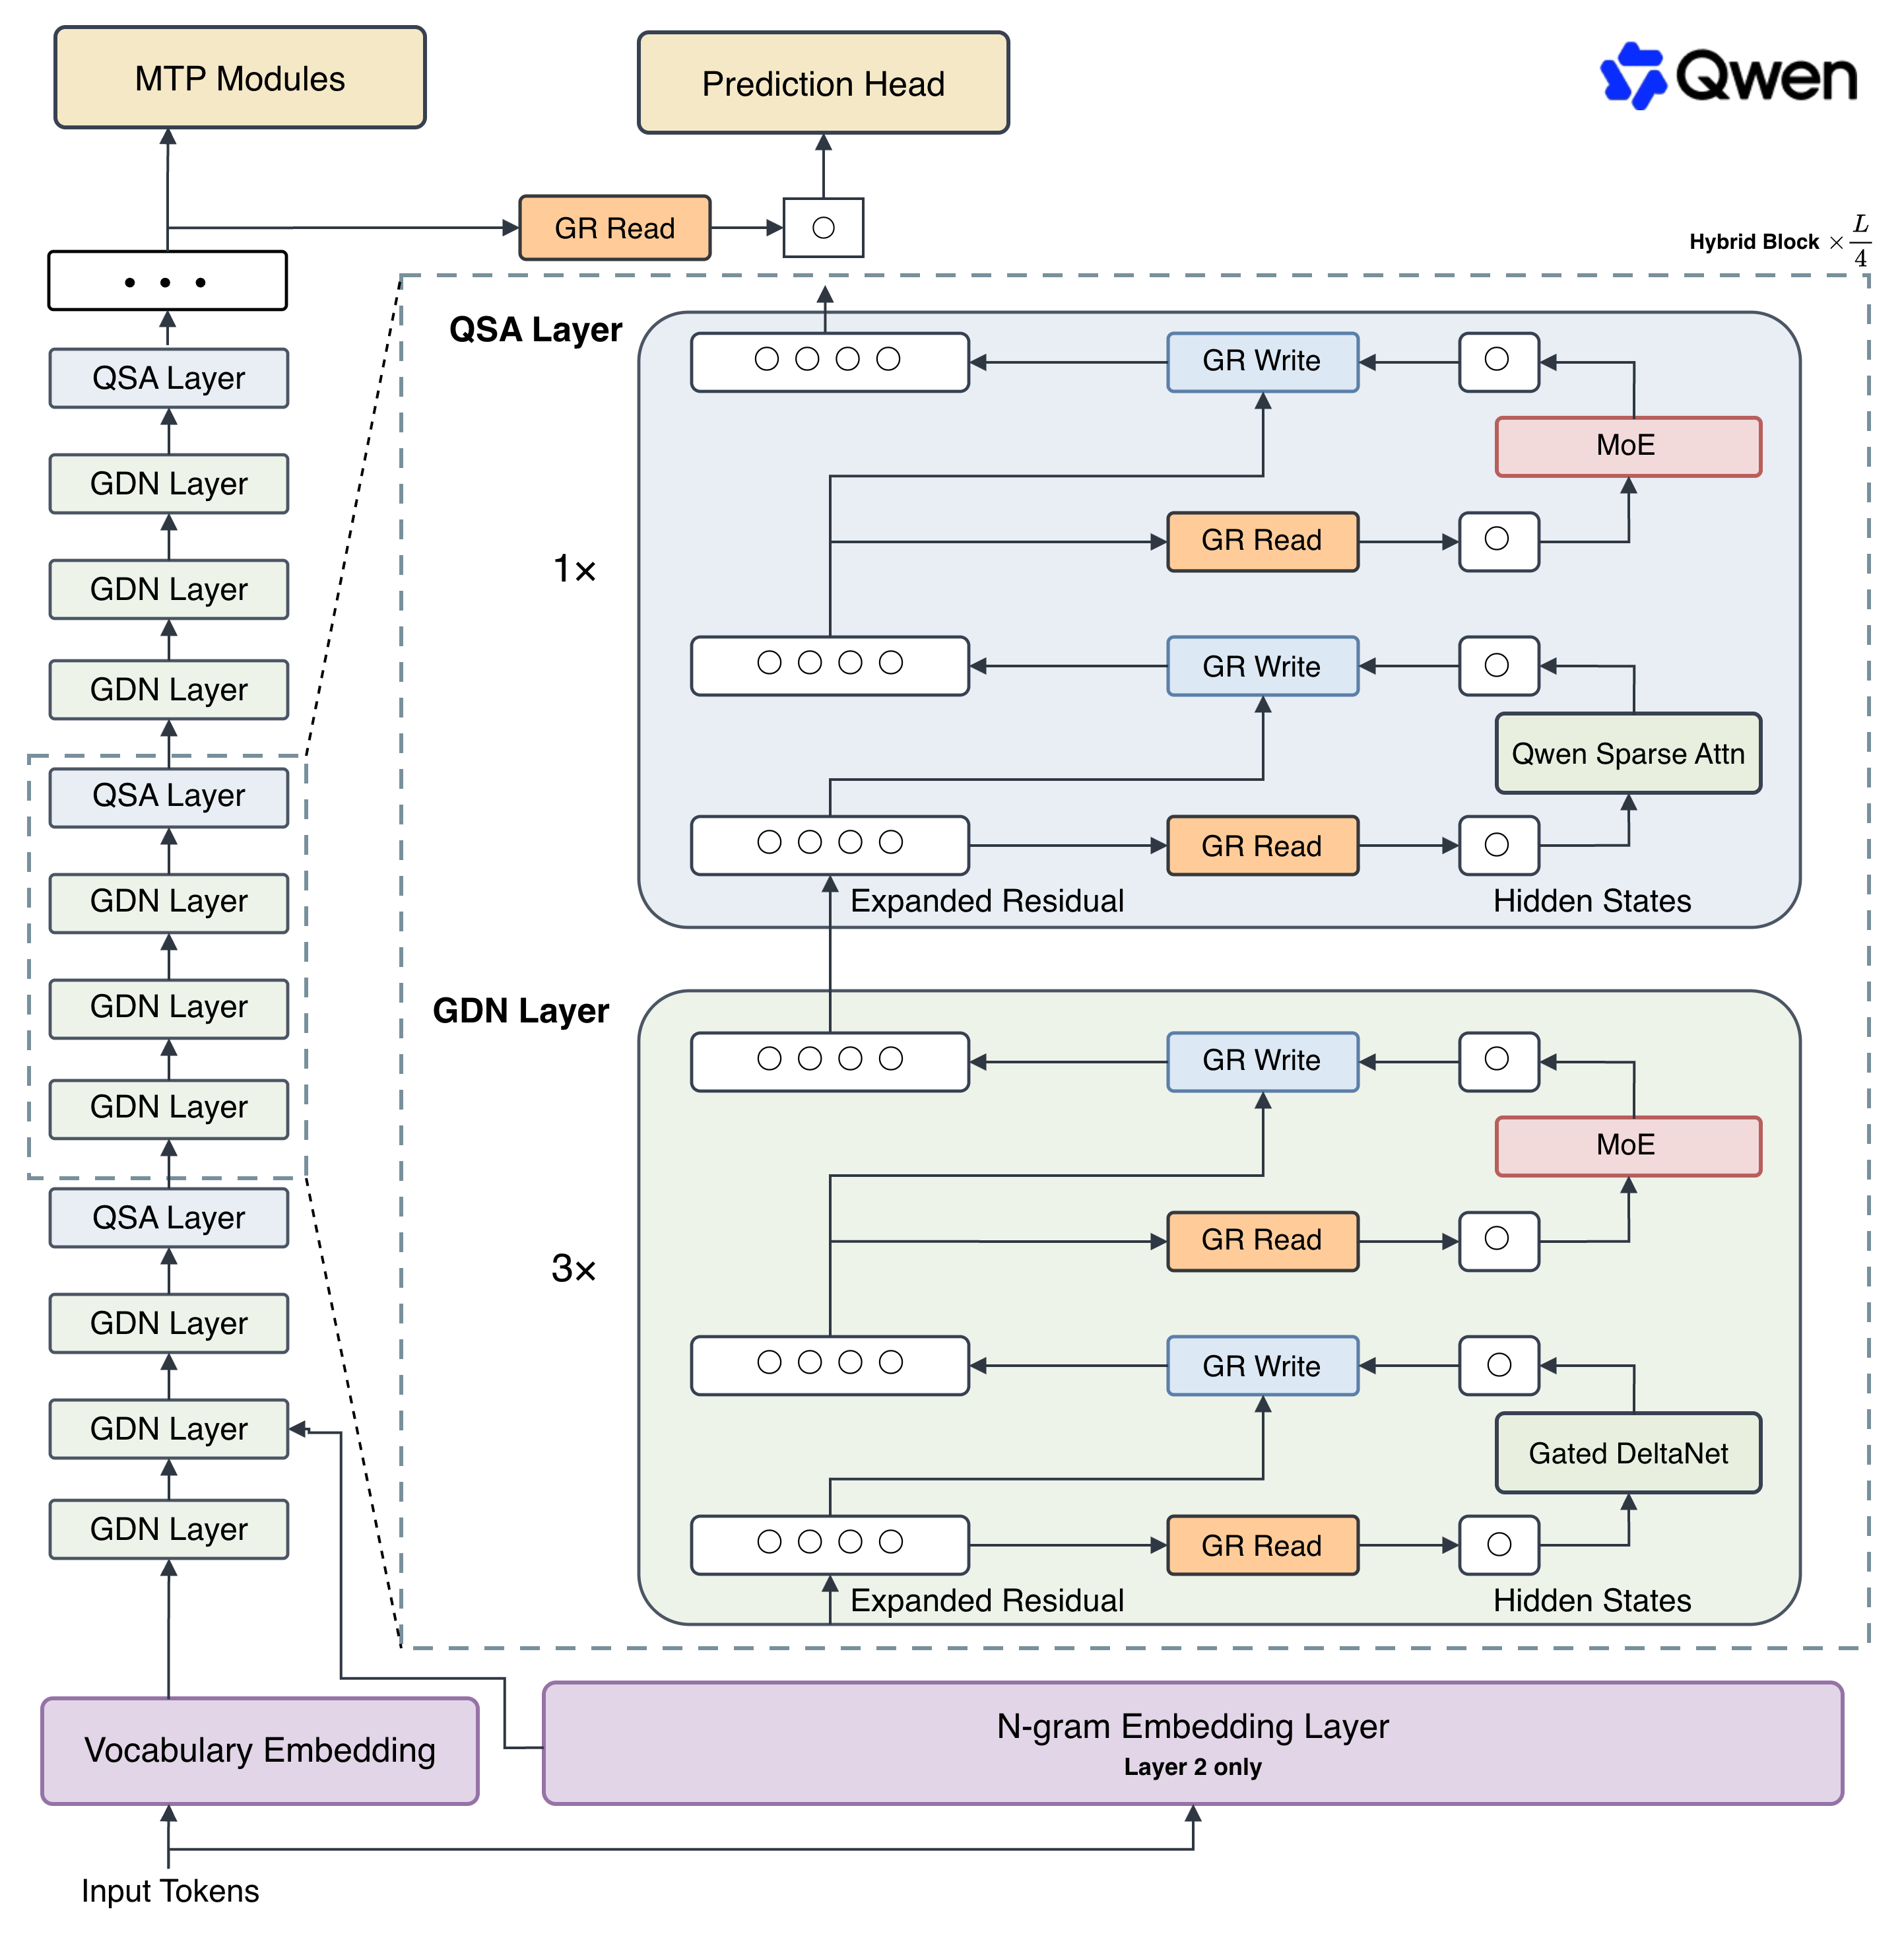
Angaben des Herstellers: Quelle · Modellkarte · Hersteller
Lauf: Moorhuhn · UD-Q4_K_XL · Reasoning xhigh · 03. September 2026
Die Zahlen auf einen Blick
Decode, Median
21,76 t/s
346 gewertete Antworten
Decode, p10 bis p90
17,15–26,28 t/s
Antworten ab 200 Tokens werden gewertet; kürzere erzeugen im Protokoll Ausreißer bis über 1 000 000 t/s, weil dort ein einzelnes Token in nahezu null Millisekunden fällt. Median klassisch, Perzentile nach Rangplatz. Beim Prefill gilt diese Schwelle NICHT, dort zählt jede Auswertung.
Spitze
33,89 t/s
einzelne Antwort
Prefill, Median
77,6 t/s
Ausgabe erzeugt
770.428 Token
nur die gewerteten Antworten ab 200 Tokens
Laufzeit
13,6 h
815 Minuten
Selbstkorrekturen
nicht gemessen
Antworten gesamt
459
346 davon gewertet
Eingabe gesamt
24,15 Mio. Token
Kontext aller 459 Anfragen zusammengezählt
davon neu berechnet
1.051.292 Token
23,10 Mio. lagen im Prompt-Cache
Durch das Modell gelaufen
24,94 Mio. Token
Eingabe und Ausgabe zusammen
Bei einem Anbieter
0,95 USD
Qwen3.8 Flash gehostet, günstigster Tarif
Was dieser Lauf gekostet hätte, wenn Qwen3.8 Flash bei einem Anbieter gelaufen wäre
| Anbieter | Eingabeje Mio. | Ausgabeje Mio. | Cacheje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|
| Alibaba Cloud Int. | 0,15 | 0,47 | 0,016 | 3,99 | 0,95 |
Alle Beträge in USD. Die ersten drei Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit denselben Token wie links: 24 148 766 Eingabe über alle Anfragen, davon 1 051 292 neu berechnet und 23 097 474 aus dem Prompt-Cache, dazu 786 506 Ausgabe. Die Spalte „ohne Cache“ setzt die ganze Eingabe zum Eingabetarif an. In der Spalte „mit Cache“ zahlt der neue Teil den Schreibtarif von 0,20 USD, der zwischengespeicherte den Lesetarif von 0,016 USD. Einziger Anbieter ist Alibaba Cloud International. Dort heißt das Modell „Qwen3.8 Flash“, ohne den Zusatz Next und ohne Angabe einer Parameterzahl. Gelaufen ist hier der Build Qwen3.8-Flash-Next von Hugging Face mit 125 Milliarden Parametern, davon 6 aktiv. Für dieselbe Herkunft sprechen derselbe Hersteller, dieselbe Kontextlänge von 1 000 000 Token und dasselbe Erscheinungsdatum; bewiesen ist es durch die Anbieterseite nicht. Stand 08.09.2026, Listenpreise ohne Mengenrabatt. Lokal kostet der Lauf statt dessen Strom und die Anschaffung des Rechners. Preise bei OpenRouter, abgerufen am 2026-09-08.
Was dieser Lauf gekostet hätte, wenn Sonnet 5 mit gleichem Tokenverbrauch gelaufen wäre
| Modell | Eingabeje Mio. | Ausgabeje Mio. | Cache schreibenje Mio. | Cache lesenje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|---|
| Sonnet 5 | 2,00 | 10,00 | 2,50 | 0,20 | 56,16 | 15,11 |
Alle Beträge in USD. Die ersten vier Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit genau den Token dieses Laufs: 24 148 766 Eingabe, davon 1 051 292 neu und 23 097 474 aus dem Cache, dazu 786 506 Ausgabe. Ohne Cache zum Eingabetarif, mit Cache zahlt der neue Teil den Schreibtarif und der zwischengespeicherte den Lesetarif. Das ist ein Vergleich unter der Annahme gleichen Tokenverbrauchs. Ein anderes Modell löst dieselbe Aufgabe mit anderer Tokenzahl, meist mit weniger; die Zeile sagt also, was diese Token bei Sonnet 5 gekostet hätten, nicht was Sonnet 5 für diese Aufgabe gekostet hätte. Preisliste von Anthropic, abgerufen am 2026-09-08.
llama.cpp-Serverlog · 346 von 459 Antworten ab 200 Tokens · Lauf vom 03./04.09.2026, 13 h 35 min. Der Server lief 844,3 Minuten am Stück. Von der ersten Aufgabe bis zum Ende der letzten sind es 837,0 Minuten; darin liegt eine Leerlaufpause von 21,9 Minuten. Das Arbeitsfenster sind also 815 Minuten. Die reine Rechenzeit auf der GPU beträgt 798,8 Minuten. · Rohprotokoll
Ergebnisse
Moorland Mayhem — Featherstorm
Öffnet in einer eigenen EbeneZielen und schiessen mit Maus oder Finger. Nachladen geht in fuenf von sieben Modi von selbst. Braucht WebGL. Im Hochformat sind die Ziele kleiner als eine Fingerkuppe — quer im Vollbild spielen.
Lädt erst auf Klick · 0,3 MB Übertragung · 1,3 MB entpackt
Prefill über Kontexttiefe
Ein Spitzenwert bei kurzem Kontext sagt wenig darüber, wie sich ein Modell nach Stunden anfühlt.
Kontexttiefe in tausend Token · Momentanrate innerhalb eines einzigen durchgehenden Prefills: Aufgabe 185882 dieses Laufs verarbeitete 69 985 Token am Stück. llama.cpp meldet dabei alle 2 048 Token einen Zwischenstand; die Rate ist der Quotient aus Token und Zeit zwischen zwei aufeinanderfolgenden Ständen. 32 Schritte bleiben übrig, Werte unter 1 500 Token sind augeschlossen. Von 2 048 auf 68 827 Token fällt die Rate um den Faktor 1,58. Jeder Punkt ist aus dem verlinkten Serverprotokoll nachvollziehbar.
llama.cpp Startparameter
- Kontext
- 131.072
- KV-Cache
- q8_0 / q8_0
- Micro-Batch
- 512
- Spekulativ
- MTP, Shared-Q8_0, n-max 2
- Build
- —
llama-server ^
  -m Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf ^
  -md mtp-Qwen3.8-Flash-Next-shared-Q8_0.gguf ^
  --spec-type draft-mtp --spec-draft-n-max 2 ^
  --mmproj mmproj-F16.gguf --alias qwen3.8-flash-next ^
  --host 127.0.0.1 --port 8099 --device Vulkan0 --gpu-layers all ^
  --n-cpu-moe 0 --fit off -fa on --load-mode mmap --lazy-mode on ^
  --ctx-size 131072 --parallel 1 --kv-unified ^
  -ctk q8_0 -ctv q8_0 -b 2048 -ub 512 ^
  --ctx-checkpoints 4 --checkpoint-min-step 4096 --jinja ^
  --reasoning on --reasoning-format deepseek ^
  --reasoning-effort xhigh --reasoning-budget 12000 ^
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0 ^
  --presence-penalty 0.0 --repeat-penalty 1.0
Einordnung
34 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
9/10
Ein sehr gutes Spielgefühl und Feedback, das Spielen macht Spaß und ist abwechslungsreich.
PräsentationMenüs, Anzeigen, Grafik, Ton
9/10
Vollständige Umsetzungen, Menüs sind schön und umfangreich designt. Bestes Ergebnis, besser als Sonnet 5.
CodequalitätTests, Struktur, Selbstkorrekturen
7/10
12 Testdateien mit 1 494 Testzeilen, kein Reparaturskript. Ordnerstruktur sinnvoll, auch einen Unterordner angelegt. Konsequente Schichtung. Settings funktionieren teilweise nicht.
UmfangWie viel vom Auftrag wurde erfüllt?
9/10
55 Dateien, 10 531 Zeilen. Fast alles aus dem Prompt wurde im Spiel auch umgesetzt.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
- Im Ladebildschirm steht „Featherstorm wordt geladen“ — Niederländisch statt Deutsch. Genau eine Stelle im ganzen Spiel; der Rest ist durchgehend deutsch.
- Das Spiel rendert auf ein 1280×720-Canvas. Auf einem 390 Pixel breiten Telefon wird es auf 390×219 herunterskaliert — spielbar, aber die Zielscheiben sind klein.
- Der Lauf brauchte drei Sitzungen (20, 376 und 419 Minuten). Zwischen den Sitzungen ging der Kontext verloren und musste neu aufgebaut werden.
llama.cpp-Serverlog · 346 von 459 Antworten ab 200 Tokens · Lauf vom 03./04.09.2026, 13 h 35 min. Der Server lief 844,3 Minuten am Stück. Von der ersten Aufgabe bis zum Ende der letzten sind es 837,0 Minuten; darin liegt eine Leerlaufpause von 21,9 Minuten. Das Arbeitsfenster sind also 815 Minuten. Die reine Rechenzeit auf der GPU beträgt 798,8 Minuten.
Bilderkennung
Wiederholung am 18.09.2026 mit den Originalbildern, nicht Teil des Laufs, in dem das Spiel entstand. Der erste Test am selben Vormittag ist ungültig: Er bekam eine verkleinerte Fassung von Bild B, und die Werkzeugbeschränkung des Agenten griff nicht.
Werte ablesen
41 von 50
Dashboard, 50 prüfbare Angaben
Preisschilder
2 von 4
vollständig richtig gelesen
Erfundene Schilder
4
1 davon als sicher behauptet
Stolperstellen erkannt
1 von 4
Stellen, die vom Muster abweichen
Vorläufig: der Lösungsschlüssel für die Preisschilder ist noch nicht vollständig gesichert.
Aufgabe 1 · Werte ablesen
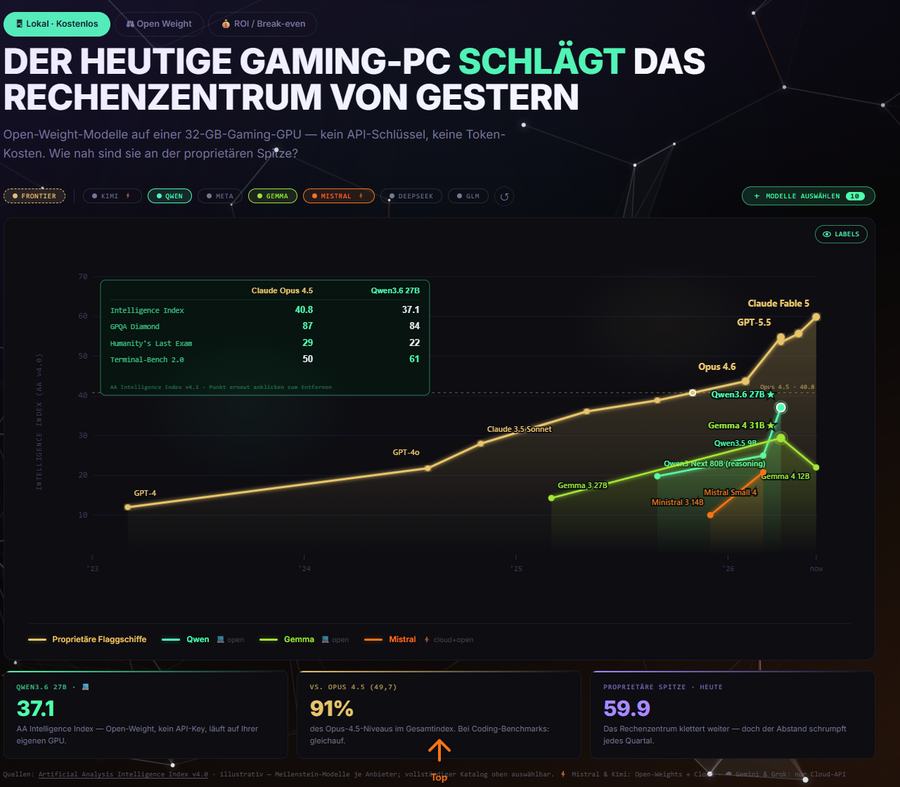
Was das Modell aus der Tooltip-Tabelle gelesen hat
| Claude Opus 4.5 | Qwen3.6 27B | |
|---|---|---|
| Intelligence Index | 40.8 | 37.1 |
| GPQA Diamond | 87 | 84 |
| Humanity's Last Exam | 29 | 22 |
| Terminal-bench 2.0 | 50 | 61 |
Und aus den Kennzahlkacheln
- QWEN3.6 27B 37.1 · AA Intelligence Index — Open-Weight, kein API-Key, läuft auf deiner eigenen GPU.
- VS. OPUS 4.5 (40,8) 91% · des Opus-4.5-Niveaus im Gesamtindex. Bei Coding-Benchmarks gleichauf.
- PROPRIETÄRE SPITZE - HEUTE 59.9 · Das Rechenzentrum klettert weiter — doch der Abstand schrumpft jedes Quartal.
Aufgabe 2 · Komplexe Schrifterkennung
Geprüft wird das Lesen von winzigen, schräg stehenden, teils verdeckten Schriften in einem Foto mit über vierzig Objekten, dazu zwei Währungszeichen, die sich bei starker Drehung kaum unterscheiden. Zum Test werden die Preisschilder verwendet.
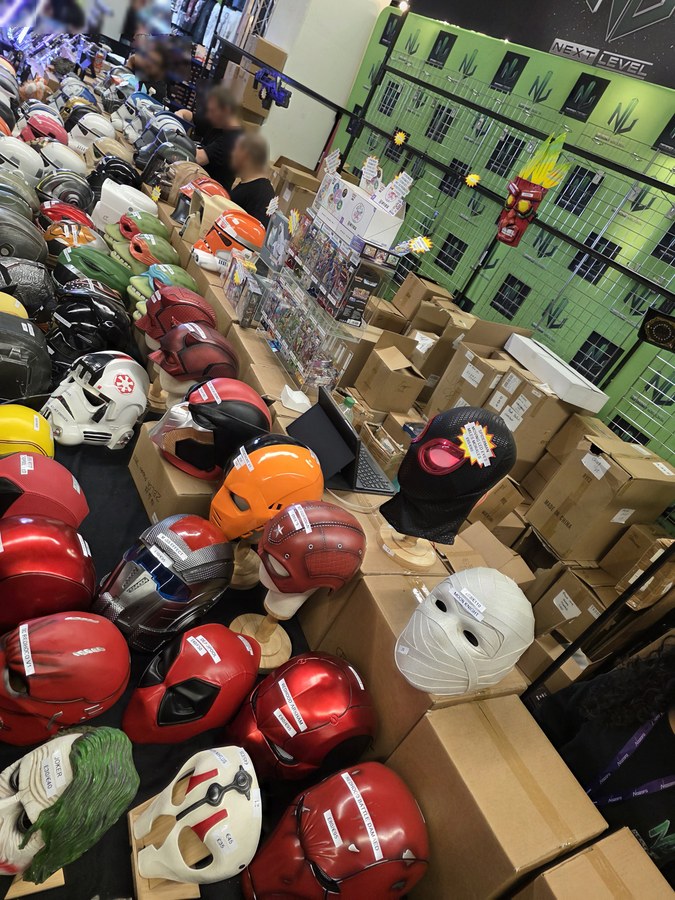
Was das Modell gelesen hat
| Was das Modell dort las | £ | € | Reihenfolge | sicher | |
|---|---|---|---|---|---|
| 1 | SENTINEL | nicht lesbar | nicht lesbar | · | nein |
| 2 | DC RECYCLED V1 | nicht lesbar | nicht lesbar | · | nein |
| 3 | DC ROYAL RED | 45 | 50 | gbp zuerst | ja |
| 4 | REDHOOD ARKHAM | 80 | 65 | gbp zuerst | ja |
| 5 | JOKER | 40 | 30 | eur zuerst | nein |
| 6 | SPIDER-MAN 2099 | 45 | 35 | gbp zuerst | nein |
| 7 | REDHOOD BATTLE DAMAGED | 80 | 65 | gbp zuerst | nein |
Das Modell zählte 7 Schilder im Wertungsbereich. Der Lösungsschlüssel steht hier bewusst nicht daneben, sonst könnte ein späteres Modell ihn von dieser Seite ablesen.
Das Modell über die schwierigste Stelle: „Die kleinen, teils schräg oder um 90° gedrehten Preisschilder in Bild B, besonders die zweizeiligen Aufkleber mit zwei Währungen in unterschiedlicher Lesbarkeit (SPIDER-MAN 2099 und REDHOOD BATTLE DAMAGED). Bei Bild A war die Zahl in Klammern im Titel der mittleren Kachel (VS. OPUS 4.5) sowie die kleinen Modellnamen am rechten Rand des Diagramms am schwersten zu lesen.“
Wo sich das Modell selbst unsicher war (7 Stellen)
- Kacheltitel 'VS. OPUS 4.5 (40,8)' — Klammerwert nicht sicher abgelesen, aus Kontext erschlossen
- Sentinel-Schild in Bild B — Name nur erahnt, Preis nicht gelesen
- DC RECYCLED V1 — kein Preis lesbar
- REDHOOD BATTLE DAMAGED — Zahlenzuordnung 80/65 nicht völlig sicher
- SPIDER-MAN 2099 — £45/€35 und deren Reihenfolge wegen Drehung unsicher
- Diagrammpunktbezeichnungen rechts (Gemma 3.5 9B, Qwen3 Next 80B (reasoning), Opus 4.5 vs. Opus 4.6 Lage) — beim Nachbau teils nur annähernd sicher
- Dashed-Line-Beschriftung am Tooltip ('Opus 4.5 – 46,8'?) — im Nachbau weggelassen
Diese Liste hat das Modell selbst geschrieben, nicht der Auswerter. Sie zählt in die Wertung: ein eingestandenes „nicht lesbar“ kostet einen Punkt, eine erfundene Angabe kostet mehr.
Die vollständige Antwort des Modells als JSON · Die Auswertung dazu steht nicht daneben: sie nennt zu jedem Fehler den richtigen Wert, und damit läge der Lösungsschlüssel offen.
Lauf: Moorhuhn · Halogen · W4B · Reasoning xhigh · 14. September 2026
Die Zahlen auf einen Blick
Decode, Median
38,28 t/s
652 gewertete Antworten
Decode, p10 bis p90
33,08–43,65 t/s
Wie bei den Läufen mit llama.cpp werden Antworten ab 200 Tokens gewertet. Median klassisch, Perzentile nach Rangplatz. Halogen schreibt je Antwort eine Zeile mit Tokens, Zeit und Rate; gewertet wird die Rate, die der Server meldet. Beim Prefill gilt die Schwelle NICHT, dort zählt jede Antwort: die neuen Tokens des Prompts geteilt durch die gemeldete Zeit für den Prefill. Daneben steht der Median ab 8 192 neuen Tokens; wie die Rate mit der Zahl neuer Tokens steigt, zeigt die Tabelle im Abschnitt Tempo.
Spitze
61,80 t/s
einzelne Antwort
Prefill ab 8.192 neuen Tokens
1120,7 t/s
Median über 39 Anfragen, 35 davon über 1.000 t/s
Prefill über alle Anfragen
347,9 t/s
Median über 891 beantwortete Anfragen; im Median kamen je Anfrage 654 neue Tokens dazu
Ausgabe erzeugt
1.144.717 Token
nur die gewerteten Antworten ab 200 Tokens
Laufzeit
11,7 h
703 Minuten
Selbstkorrekturen
nicht gemessen
Antworten gesamt
891
652 davon gewertet; 917 Anfragen gesendet
Eingabe gesamt
50,51 Mio. Token
Kontext aller 891 beantworteten Anfragen zusammengezählt
davon neu berechnet
2.862.509 Token
47,65 Mio. lagen im Prompt-Cache
Durch das Modell gelaufen
51,69 Mio. Token
Eingabe und Ausgabe zusammen
Serverprotokoll von Halogen 0.6.3, mitgeschrieben über einen Proxy · 652 von 891 Antworten ab 200 Tokens · Lauf vom 14./15.09.2026. Das Protokoll beginnt am 14.09. um 15:32:17 Uhr und endet am 15.09. um 10:13:53 Uhr, das sind 1 121,6 Minuten. Zwischen dem Ende einer Antwort und der nächsten Anfrage liegen darin sieben Pausen über 60 Sekunden, zusammen 418,3 Minuten, die längste mit 292,9 Minuten in der Nacht. Das Arbeitsfenster sind also 703 Minuten. Die reine Rechenzeit des Servers beträgt 634,9 Minuten. · Rohprotokoll
Ergebnisse
Moorland Mayhem – Federsturm
Öffnet in einer eigenen EbeneLinksklick oder Leertaste schießt, Rechtsklick oder R lädt nach, Escape pausiert.
Lädt erst auf Klick · 0,3 MB Übertragung · 1,7 MB entpackt
Decode über Kontexttiefe
Ein Spitzenwert bei kurzem Kontext sagt wenig darüber, wie sich ein Modell nach Stunden anfühlt.
Kontexttiefe in tausend Token · Die 652 gewerteten Antworten nach ihrer Promptgröße sortiert und in sechs gleich große Gruppen geteilt; je Punkt der Median der Promptgröße und der Median der Geschwindigkeit. Gemessen zwischen 729 und 143 082 Token Kontext. 268 dieser Antworten liefen neben einer zweiten Anfrage, Halogen bedient zwei Slots. Jeder Punkt ist aus dem verlinkten Serverprotokoll nachvollziehbar.
Prefill nach der Zahl neuer Tokens je Anfrage
Halogen schreibt je Anfrage die Tokens im Prompt, den Teil davon aus dem Cache und die Zeit für den Prefill ins Protokoll. Die Rate ist die Zahl der neuen Tokens geteilt durch diese Zeit. Im Agentenbetrieb bringt eine Anfrage im Median nur 654 neue Tokens mit, und Anfragen mit 32 bis 511 neuen Tokens brauchten im Median schon 1,46 s. Deshalb liegt der Median über alle 891 beantworteten Anfragen bei 347,85 t/s, ab 8 192 neuen Tokens dagegen bei 1 120,69 t/s.
| Neue Tokens je Anfrage | Anfragen | ZeitMedian | RateMedian |
|---|---|---|---|
| 1 bis 31 | 16 | 0,06 s | 83,33 t/s |
| 32 bis 511 | 372 | 1,46 s | 175,38 t/s |
| 512 bis 2.047 | 351 | 2,13 s | 436,14 t/s |
| 2.048 bis 8.191 | 113 | 4,04 s | 761,70 t/s |
| 8.192 bis 32.767 | 20 | 16,07 s | 1092,83 t/s |
| ab 32.768 | 19 | 70,48 s | 1171,72 t/s |
Alle 891 beantworteten Anfragen nach der Zahl ihrer neuen Tokens in sechs Stufen geteilt, Zeit und Rate je Stufe als Median. Nachvollziehbar in den Zeilen serve_api des verlinkten Serverprotokolls; parse_logs.py im Belegrepo gibt die Stufen und den Wert ab 8 192 neuen Tokens aus.
Serverkonfiguration
- Server
- halogen-flash-server 0.6.3
- Container
- ghcr.io/peonist-ai/halogen-flash-server:0.6.3
- Gewichte
- W4B mit Qualitäts-Overlay, 741 Tensoren, 2,40 GiB
- Kontext
- 262 144 je Anfrage, ein KV-Pool für zwei Slots
- Spekulativ
- MTP mit Tiefe 1, nur solange kein zweiter Strom läuft, dazu Prompt Lookup (pld im Protokoll)
- Reasoning
- xhigh
- Sampling
- temp 1.0 · top_p 0.95 · top_k 20 · min_p 0.0 · presence 0.0, nur für Felder, die die Anfrage nicht setzt
- Bilderkennung
- an
- Speicher
- 68,0 GiB Gewichte im RAM gesperrt, 7,2 GiB KV-Pool, 21,1 GiB Arbeitsspeicher
- Nachschlagetabelle
- 47,7 GiB, liest der Server bei Bedarf von der Platte
- iGPU
- 2,0 GiB in der Firmware für die iGPU reserviert
- System
- Linux
  Halogen Qwen3.8-Flash-Next W4B + Qualitaets-Overlay + Vision  (ghcr.io/peonist-ai/halogen-flash-server:0.6.3)

  Kontext  : 262144 je Request, KV-Pool 262144 Positionen, 2 Slot
  Budget   : max_tokens-Default 65536 je Anfrage, Cap 262144, Slots 2
  Reasoning: xhigh, getrennt in reasoning_content
  Sampling : temp 1.0  top_p 0.95  top_k 20  min_p 0.0  presence 0.0  (nur fuer fehlende Felder)
  Cache    : Prompt-Cache 2, Queue-Timeout 28800 s
  Vision   : an (qwen38-flash-next-vision.hgn)
  RAM      : 123 GiB sichtbar, 13 GiB belegt, 1179 freie 2-MiB-Bloecke
  Endpoint : http://127.0.0.1:18099/v1 (VS Code ueber Live-Log-Proxy :8099)   Modell: halogen-qwen3.8-flash-next-w4b-quality-overlay
  Watchdog : 0 (0 = aus)

  Laden: gemessen 30 s (13.09., Pool 32768); bei fragmentiertem Speicher ueber 5 min.
Alle Angaben stammen aus dem Kopf und den Startmeldungen des Rohprotokolls. Eine Startzeile wie bei llama.cpp gibt es nicht, Halogen läuft als Container. Oben der Kopf, den das Startskript ins Protokoll schreibt, wörtlich.
Einordnung
32 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
8/10
Gutes Feedback, es macht Spaß zu spielen. Es könnte aber etwas abwechslungsreicher sein und sich noch etwas runder anfühlen.
PräsentationMenüs, Anzeigen, Grafik, Ton
9/10
Es sind ein paar Fehler in der Darstellung, die Flügel sind z.B. falscherhum. Die Menus und das Gesamtdesign sind jedoch sehr überzeugend.
CodequalitätTests, Struktur, Selbstkorrekturen
7/10
Vereinzelte Codedateien sind zu groß, ansonsten ist der Code aber ordentlich und es wurde sich an die vorgegebene Struktur gehalten. 169 Unittests für die Logik wurden erstellt. Die Namen für die Funktionen passen und sind verständlich.
UmfangWie viel vom Auftrag wurde erfüllt?
8/10
Das Spiel wurde umfangreich umgesetzt. Einzelne Funktionen sind fehlerhaft z.B. wird der Präzisionsbonus nicht angewandt und der Lautstärkeregler lässt sich nicht ziehen.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
- Beim Start meldete der Server 13,7 GiB bereits belegten Arbeitsspeicher und warnte, dass der Prefill dadurch mehrfach langsamer laufen kann als veröffentlicht und Pausen von einer Minute und mehr möglich sind.
- 15 Anfragen endeten mit HTTP 400, ohne ein einziges Token, 14 davon zwischen 16:11 und 16:13 Uhr. Um 17:08 Uhr endete eine weitere mit HTTP 504.
- Sieben Antworten liefen zwischen 17:28 und 18:50 Uhr in ihre Obergrenze von 8 192 Tokens und brachen dort ab.
- Zwischen 23:46 und 00:18 Uhr brach der Server drei Anfragen ab: zweimal, weil die Engine beim Decode 300 Sekunden lang nichts lieferte, einmal beim Prefill 1 800 Sekunden lang.
- Um 07:31 und um 07:38 Uhr trennte VS Code die Verbindung mitten in einer Antwort.
- Um 08:22 Uhr lehnte der Server zwei Anfragen ab: angekündigt waren drei Bilder, angekommen ist keins.
- Die Zahl der Nachrichten je Anfrage fällt im Protokoll 25 Mal auf höchstens sieben zurück, zuletzt um 08:33 Uhr von 311 auf 7.
Serverprotokoll von Halogen 0.6.3, mitgeschrieben über einen Proxy · 652 von 891 Antworten ab 200 Tokens · Lauf vom 14./15.09.2026. Das Protokoll beginnt am 14.09. um 15:32:17 Uhr und endet am 15.09. um 10:13:53 Uhr, das sind 1 121,6 Minuten. Zwischen dem Ende einer Antwort und der nächsten Anfrage liegen darin sieben Pausen über 60 Sekunden, zusammen 418,3 Minuten, die längste mit 292,9 Minuten in der Nacht. Das Arbeitsfenster sind also 703 Minuten. Die reine Rechenzeit des Servers beträgt 634,9 Minuten.
Bilderkennung
Wiederholung am 18.09.2026 mit den Originalbildern und dem eigenen Agenten, nicht Teil des Laufs, in dem das Spiel entstand. Der erste Test vom 17.09. ist ungültig: Er bekam eine verkleinerte Fassung von Bild B und lief im eingebauten Agent-Modus.
Werte ablesen
42 von 50
Dashboard, 50 prüfbare Angaben
Preisschilder
1 von 4
vollständig richtig gelesen
Erfundene Schilder
2
1 davon als sicher behauptet
Stolperstellen erkannt
3 von 4
Stellen, die vom Muster abweichen
Vorläufig: der Lösungsschlüssel für die Preisschilder ist noch nicht vollständig gesichert.
Aufgabe 1 · Werte ablesen
Was das Modell aus der Tooltip-Tabelle gelesen hat
| Claude Opus 4.5 | Qwen3.6 27B | |
|---|---|---|
| Intelligence Index | 40.8 | 37.1 |
| GPU Diamond | 87 | 84 |
| Humanity's Last Exam | 29 | 72 |
| Terminal-Bench 2.0 | 50 | 61 |
Und aus den Kennzahlkacheln
- QWEN3.6 27B 37.1 · AA Intelligence Index — Open-Weight, kein API-Key, läuft auf deiner eigenen GPU.
- VS. OPUS 4.5 (40,7) 91% · des Opus-4.5-Niveaus im Gesamtrating. Bei Coding-Benchmarks: gleichauf.
- PROPRIETÄRE SPITZE · HEUTE 59.9 · Das Rechenzentrum klettert weiter — doch der Abstand schrumpft jedes Quartal.
Aufgabe 2 · Komplexe Schrifterkennung
Geprüft wird das Lesen von winzigen, schräg stehenden, teils verdeckten Schriften in einem Foto mit über vierzig Objekten, dazu zwei Währungszeichen, die sich bei starker Drehung kaum unterscheiden. Zum Test werden die Preisschilder verwendet.
Was das Modell gelesen hat
| Was das Modell dort las | £ | € | Reihenfolge | sicher | |
|---|---|---|---|---|---|
| 1 | REDHOOD OVI | 30 | 40 | gbp zuerst | ja |
| 2 | RED HOOD INFERNO | 60 | 65 | gbp zuerst | ja |
| 3 | REDHOOD BADLAND DAMAGED | 80 | 95 | gbp zuerst | nein |
| 4 | REDHOOD BATTLE DAMAGED | 80 | 95 | gbp zuerst | nein |
| 5 | JOKER | 30 | 40 | gbp zuerst | ja |
| 6 | UNHOLLOWED | 45 | 35 | gbp zuerst | nein |
Das Modell zählte 6 Schilder im Wertungsbereich. Der Lösungsschlüssel steht hier bewusst nicht daneben, sonst könnte ein späteres Modell ihn von dieser Seite ablesen.
Das Modell über die schwierigste Stelle: „Die winzige Tooltip-Fußnote und die feinen Datenpunkt-Beschriftungen im Diagramm (z. B. das kleine 'Opus 4.5 · 40.8' rechts); bei Bild B die Unterscheidung von 'BADLAND' vs. 'BATTLE DAMAGED' auf zwei nahezu identischen roten Helmen und die Währungszeichen auf dem weißen 'UNHOLLOWED'-Schild.“
Wo sich das Modell selbst unsicher war (8 Stellen)
- Tooltip-Fussnote (lautere 'AA Intelligence Index v0.6 · …', Rest unleserlich)
- Kachel 2: Klammerwert '(40,7)' — könnte '(49,7)' sein
- x-Achse: ob rechts noch ein Tick '27 existiert
- Legenden-Badges: 'open' bei Gemma und 'cloud+open' bei Mistral nicht pixelgenau bestätigt
- 'Mistral S 4' — Schreibweise des Modells nicht 100% sicher
- 'REDHOOD OVI' — könnte 'OV1' heißen
- UNHOLLOWED-Schild: Währungssymbole (£/€) nicht sicher lesbar
- Humanity's Last Exam: 72 auf der Qwen-Seite überrascht mich, ist aber so lesbar
Diese Liste hat das Modell selbst geschrieben, nicht der Auswerter. Sie zählt in die Wertung: ein eingestandenes „nicht lesbar“ kostet einen Punkt, eine erfundene Angabe kostet mehr.
Die vollständige Antwort des Modells als JSON · Die Auswertung dazu steht nicht daneben: sie nennt zu jedem Fehler den richtigen Wert, und damit läge der Lösungsschlüssel offen.
Lauf: Clair Obscure · UD-Q4_K_XL · Reasoning xhigh · 01. September 2026
Die Zahlen auf einen Blick
Decode, Median
10,93 t/s
92 gewertete Antworten
Decode, p10 bis p90
9,70–13,85 t/s
Antworten ab 200 Tokens werden gewertet; kürzere erzeugen im Protokoll Ausreißer bis über 1 000 000 t/s, weil dort ein einzelnes Token in nahezu null Millisekunden fällt. Median klassisch, Perzentile nach Rangplatz. Beim Prefill gilt diese Schwelle NICHT, dort zählt jede Auswertung.
Spitze
17,01 t/s
einzelne Antwort
Prefill, Median
109,7 t/s
Ausgabe erzeugt
236.460 Token
nur die gewerteten Antworten ab 200 Tokens
Laufzeit
6,2 h
370 Minuten
Selbstkorrekturen
nicht gemessen
Antworten gesamt
106
92 davon gewertet
Eingabe gesamt
8,15 Mio. Token
Kontext aller 106 Anfragen zusammengezählt
davon neu berechnet
251.883 Token
7,90 Mio. lagen im Prompt-Cache
Durch das Modell gelaufen
8,39 Mio. Token
Eingabe und Ausgabe zusammen
Bei einem Anbieter
0,29 USD
Qwen3.8 Flash gehostet, günstigster Tarif
Was dieser Lauf gekostet hätte, wenn Qwen3.8 Flash bei einem Anbieter gelaufen wäre
| Anbieter | Eingabeje Mio. | Ausgabeje Mio. | Cacheje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|
| Alibaba Cloud Int. | 0,15 | 0,47 | 0,016 | 1,34 | 0,29 |
Alle Beträge in USD. Die ersten drei Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit denselben Token wie links: 8 153 803 Eingabe über alle Anfragen, davon 251 883 neu berechnet und 7 901 920 aus dem Prompt-Cache, dazu 238 371 Ausgabe. Die Spalte „ohne Cache“ setzt die ganze Eingabe zum Eingabetarif an. In der Spalte „mit Cache“ zahlt der neue Teil den Schreibtarif von 0,20 USD, der zwischengespeicherte den Lesetarif von 0,016 USD. Einziger Anbieter ist Alibaba Cloud International. Dort heißt das Modell „Qwen3.8 Flash“, ohne den Zusatz Next und ohne Angabe einer Parameterzahl. Gelaufen ist hier der Build Qwen3.8-Flash-Next von Hugging Face mit 125 Milliarden Parametern, davon 6 aktiv. Für dieselbe Herkunft sprechen derselbe Hersteller, dieselbe Kontextlänge von 1 000 000 Token und dasselbe Erscheinungsdatum; bewiesen ist es durch die Anbieterseite nicht. Stand 08.09.2026, Listenpreise ohne Mengenrabatt. Lokal kostet der Lauf statt dessen Strom und die Anschaffung des Rechners. Preise bei OpenRouter, abgerufen am 2026-09-08.
Was dieser Lauf gekostet hätte, wenn Sonnet 5 mit gleichem Tokenverbrauch gelaufen wäre
| Modell | Eingabeje Mio. | Ausgabeje Mio. | Cache schreibenje Mio. | Cache lesenje Mio. | Dieser Laufohne Cache | Dieser Laufmit Cache |
|---|---|---|---|---|---|---|
| Sonnet 5 | 2,00 | 10,00 | 2,50 | 0,20 | 18,69 | 4,59 |
Alle Beträge in USD. Die ersten vier Spalten sind Tarife je Million Token, die letzten beiden die Summe für diesen Lauf. Gerechnet mit genau den Token dieses Laufs: 8 153 803 Eingabe, davon 251 883 neu und 7 901 920 aus dem Cache, dazu 238 371 Ausgabe. Ohne Cache zum Eingabetarif, mit Cache zahlt der neue Teil den Schreibtarif und der zwischengespeicherte den Lesetarif. Das ist ein Vergleich unter der Annahme gleichen Tokenverbrauchs. Ein anderes Modell löst dieselbe Aufgabe mit anderer Tokenzahl, meist mit weniger; die Zeile sagt also, was diese Token bei Sonnet 5 gekostet hätten, nicht was Sonnet 5 für diese Aufgabe gekostet hätte. Preisliste von Anthropic, abgerufen am 2026-09-08.
llama.cpp-Serverlog · 92 von 106 Antworten ab 200 Tokens · Lauf vom August 2026. Der Server lief 374,4 Minuten am Stück. Von der ersten Aufgabe bis zum Ende der letzten sind es 369,7 Minuten, ohne eine einzige Pause über 60 Sekunden dazwischen. Die reine Rechenzeit auf der GPU beträgt 368,1 Minuten. · Rohprotokoll
Ergebnisse
Clair Obscur Echo — Studio of the Gilded Hour
Öffnet in einer eigenen EbeneMaus und Tastatur. Angriffe des Gegners werden angekündigt, Parieren und Ausweichen laufen in Echtzeit. Braucht WebGL.
Lädt erst auf Klick · 0,3 MB Übertragung · 1,7 MB entpackt
Prefill über Kontexttiefe
Ein Spitzenwert bei kurzem Kontext sagt wenig darüber, wie sich ein Modell nach Stunden anfühlt.
Kontexttiefe in tausend Token · Momentanrate innerhalb eines einzigen durchgehenden Prefills: Aufgabe 176155 dieses Laufs verarbeitete 35 009 Token am Stück. llama.cpp meldet dabei alle 2 048 Token einen Zwischenstand; die Rate ist der Quotient aus Token und Zeit zwischen zwei aufeinanderfolgenden Ständen. 15 Schritte bleiben übrig, Reststücke unter 1 500 Token sind verworfen, weil dort der Aufruf-Overhead misst statt der Tiefe. Von 2 048 auf 33 642 Token fällt die Rate um den Faktor 1,19. Jeder Punkt ist aus dem verlinkten Serverprotokoll nachrechenbar.
llama.cpp Startparameter
- Kontext
- 262.144
- KV-Cache
- q8_0 / q8_0
- Micro-Batch
- 512
- Spekulativ
- MTP, ältere Fassung (nicht die von Unsloth)
- Build
- 580e88d
llama-server -m Qwen3.8-Flash-Next-UD-Q4_K_XL-00001-of-00004.gguf ^
  --mmproj mmproj-F16.gguf --alias qwen3.8-flash-next ^
  --host 127.0.0.1 --port 8099 --device Vulkan0 ^
  --gpu-layers all --n-cpu-moe 0 --fit off -fa on ^
  --load-mode mmap --lazy-mode on ^
  --ctx-size 262144 --parallel 1 --kv-unified ^
  -ctk q8_0 -ctv q8_0 -b 2048 -ub 512 ^
  --ctx-checkpoints 4 --checkpoint-min-step 4096 ^
  --jinja --reasoning on --reasoning-format deepseek --reasoning-effort xhigh
Einordnung
22 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
6/10
Kampfarena läuft, Parieren und Ausweichen sind angelegt.
PräsentationMenüs, Anzeigen, Grafik, Ton
6/10
Aufnahme vorhanden.
CodequalitätTests, Struktur, Selbstkorrekturen
4/10
Keine Testdateien; auch keine Reparaturskripte.
UmfangWie viel vom Auftrag wurde erfüllt?
6/10
29 Dateien, 6 157 Zeilen.
Diese Bewertung ist ein Vorschlag und von Kai Bennett noch nicht bestätigt. Codequalität und Umfang stützen sich auf ausgezählte Dateien, Quell- und Testzeilen sowie Reparaturskripte im Belegrepo.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
Keine Selbstkorrekturen protokolliert.
llama.cpp-Serverlog · 92 von 106 Antworten ab 200 Tokens · Lauf vom August 2026. Der Server lief 374,4 Minuten am Stück. Von der ersten Aufgabe bis zum Ende der letzten sind es 369,7 Minuten, ohne eine einzige Pause über 60 Sekunden dazwischen. Die reine Rechenzeit auf der GPU beträgt 368,1 Minuten.
Bilderkennung
Für diesen Lauf gibt es keinen eigenen Bildtest. Gezeigt wird der aus dem Lauf „Moorhuhn · UD-Q4_K_XL · Reasoning xhigh“.
Wiederholung am 18.09.2026 mit den Originalbildern, nicht Teil des Laufs, in dem das Spiel entstand. Der erste Test am selben Vormittag ist ungültig: Er bekam eine verkleinerte Fassung von Bild B, und die Werkzeugbeschränkung des Agenten griff nicht.
Werte ablesen
41 von 50
Dashboard, 50 prüfbare Angaben
Preisschilder
2 von 4
vollständig richtig gelesen
Erfundene Schilder
4
1 davon als sicher behauptet
Stolperstellen erkannt
1 von 4
Stellen, die vom Muster abweichen
Vorläufig: der Lösungsschlüssel für die Preisschilder ist noch nicht vollständig gesichert.
Aufgabe 1 · Werte ablesen
Was das Modell aus der Tooltip-Tabelle gelesen hat
| Claude Opus 4.5 | Qwen3.6 27B | |
|---|---|---|
| Intelligence Index | 40.8 | 37.1 |
| GPQA Diamond | 87 | 84 |
| Humanity's Last Exam | 29 | 22 |
| Terminal-bench 2.0 | 50 | 61 |
Und aus den Kennzahlkacheln
- QWEN3.6 27B 37.1 · AA Intelligence Index — Open-Weight, kein API-Key, läuft auf deiner eigenen GPU.
- VS. OPUS 4.5 (40,8) 91% · des Opus-4.5-Niveaus im Gesamtindex. Bei Coding-Benchmarks gleichauf.
- PROPRIETÄRE SPITZE - HEUTE 59.9 · Das Rechenzentrum klettert weiter — doch der Abstand schrumpft jedes Quartal.
Aufgabe 2 · Komplexe Schrifterkennung
Geprüft wird das Lesen von winzigen, schräg stehenden, teils verdeckten Schriften in einem Foto mit über vierzig Objekten, dazu zwei Währungszeichen, die sich bei starker Drehung kaum unterscheiden. Zum Test werden die Preisschilder verwendet.
Was das Modell gelesen hat
| Was das Modell dort las | £ | € | Reihenfolge | sicher | |
|---|---|---|---|---|---|
| 1 | SENTINEL | nicht lesbar | nicht lesbar | · | nein |
| 2 | DC RECYCLED V1 | nicht lesbar | nicht lesbar | · | nein |
| 3 | DC ROYAL RED | 45 | 50 | gbp zuerst | ja |
| 4 | REDHOOD ARKHAM | 80 | 65 | gbp zuerst | ja |
| 5 | JOKER | 40 | 30 | eur zuerst | nein |
| 6 | SPIDER-MAN 2099 | 45 | 35 | gbp zuerst | nein |
| 7 | REDHOOD BATTLE DAMAGED | 80 | 65 | gbp zuerst | nein |
Das Modell zählte 7 Schilder im Wertungsbereich. Der Lösungsschlüssel steht hier bewusst nicht daneben, sonst könnte ein späteres Modell ihn von dieser Seite ablesen.
Das Modell über die schwierigste Stelle: „Die kleinen, teils schräg oder um 90° gedrehten Preisschilder in Bild B, besonders die zweizeiligen Aufkleber mit zwei Währungen in unterschiedlicher Lesbarkeit (SPIDER-MAN 2099 und REDHOOD BATTLE DAMAGED). Bei Bild A war die Zahl in Klammern im Titel der mittleren Kachel (VS. OPUS 4.5) sowie die kleinen Modellnamen am rechten Rand des Diagramms am schwersten zu lesen.“
Wo sich das Modell selbst unsicher war (7 Stellen)
- Kacheltitel 'VS. OPUS 4.5 (40,8)' — Klammerwert nicht sicher abgelesen, aus Kontext erschlossen
- Sentinel-Schild in Bild B — Name nur erahnt, Preis nicht gelesen
- DC RECYCLED V1 — kein Preis lesbar
- REDHOOD BATTLE DAMAGED — Zahlenzuordnung 80/65 nicht völlig sicher
- SPIDER-MAN 2099 — £45/€35 und deren Reihenfolge wegen Drehung unsicher
- Diagrammpunktbezeichnungen rechts (Gemma 3.5 9B, Qwen3 Next 80B (reasoning), Opus 4.5 vs. Opus 4.6 Lage) — beim Nachbau teils nur annähernd sicher
- Dashed-Line-Beschriftung am Tooltip ('Opus 4.5 – 46,8'?) — im Nachbau weggelassen
Diese Liste hat das Modell selbst geschrieben, nicht der Auswerter. Sie zählt in die Wertung: ein eingestandenes „nicht lesbar“ kostet einen Punkt, eine erfundene Angabe kostet mehr.
Die vollständige Antwort des Modells als JSON · Die Auswertung dazu steht nicht daneben: sie nennt zu jedem Fehler den richtigen Wert, und damit läge der Lösungsschlüssel offen.
Quellen
- Modellgewichtehuggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF
- Modellkartehuggingface.co/Qwen/Qwen3.8-Flash-Next
- Herstellerseiteqwen.ai
- Messdaten-Repogithub.com/KaiFelixBennett/local-ai-amd-benchmark
- Rohprotokoll dieses Laufsgithub.com/KaiFelixBennett/local-ai-amd-benchmark/blob/main/evidence/logs/qwen38-flashnext-moorhuhn-evox2.log
- Quelltext · Moorhuhn · UD-Q4_K_XL · Reasoning xhighgithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/qwen38-flashnext/moorhuhn-q4xl
- Quelltext · Moorhuhn · Halogen · W4B · Reasoning xhighgithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/qwen38-flashnext/moorhuhn-halogen
- Quelltext · Clair Obscure · UD-Q4_K_XL · Reasoning xhighgithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/qwen38-flashnext/clairobscure-q4xl
- Server Halogengithub.com/peonist-ai/halogen-flash-server
- Gewichte für Halogenhuggingface.co/peonist-ai/halogen-qwen3.8-flash-next
Selbst ausprobieren
- Gewichte laden · Bezugsquelle
- llama-server mit der Startzeile oben starten
- Den Endpunkt in VS Code als eigenes Modell eintragen und den Agenten wählen
Auftrag, Agentdateien und Werkzeuge: Agent Test Harness
Zitieren: Kai Felix Bennett, „Nutzbarkeitstest von lokaler KI auf AMD-Hardware", benchmark.securesight.ai, Lauf qwen38-flashnext-moorhuhn-evox2. Messdaten CC-BY-4.0.
Messdaten CC-BY-4.0, Code MIT.