Cloud-Referenz
Sonnet 5
Cloud-Referenz
- Hardware
- Cloud-Referenz—
- Speicher
- —
- Aufgaben
- Moorhuhn, Bilderkennung
- Quantisierungen
- —
Beschreibung des Modells
Anthropic veröffentlicht zu Claude Sonnet 5 keine Architekturdaten. Weder die Modellseite der Claude-Plattform noch die System Card vom 30. Juni 2026 nennen Parameterzahl, Schichtzahl oder ob das Modell dicht oder als Mixture of Experts aufgebaut ist. Dokumentiert sind ausschließlich Betriebsdaten: 1 Million Token Kontextfenster, 128 000 Token maximale Ausgabe, Text und Bilder als Eingabe, Text als Ausgabe, adaptives Denken mit fünf Effort-Stufen und ein Trainingsdaten-Cutoff im Januar 2026. Die System Card beschreibt das Training als proprietäre Mischung aus öffentlich verfügbaren Internetdaten, öffentlichen und privaten Datensätzen sowie synthetischen Daten anderer Modelle, ohne Angaben zu Rechenaufwand oder Datenmenge.
- Modell-ID
- claude-sonnet-5
- Kontextfenster
- 1 000 000 Token
- Maximale Ausgabe
- 128 000 Token
- Maximale Ausgabe (Batch API, Beta)
- 300 000 Token
- Ein- und Ausgabe
- Text und Bilder zu Text
- Denkmodus
- Adaptives Denken, standardmäßig aktiv
- Effort-Stufen
- low, medium, high, xhigh, max; Standard high
- Tokenizer
- Rund 30 Prozent mehr Token je Text als bei Sonnet 4.6
Angaben des Herstellers: Quelle · Modellkarte · Hersteller
Die Zahlen auf einen Blick
Der Lauf ging über eine fremde Schnittstelle. Es gibt kein Serverprotokoll, also weder Geschwindigkeit noch Tokenbilanz. Was zählt, ist das Artefakt.
Laufzeit
1,2 h
70 Minuten
Selbstkorrekturen
2
Cloud-Referenz über die Anthropic-API. Das Artefakt liegt vor, die Geschwindigkeit ist nicht vergleichbar gemessen. Die Laufzeit von rund 70 Minuten ist aus der Sitzung notiert, nicht aus einem Protokoll gerechnet.
Ergebnisse
Moorland Mayhem — Featherstorm
Öffnet in einer eigenen EbeneZielen und schießen mit Maus oder Finger. Braucht WebGL.
Lädt erst auf Klick · 0,3 MB Übertragung · 1,6 MB entpackt
Einordnung
32 / 40
Die Note ist eine persönliche also subjektive Einschätzung.
SpielgefühlLäuft es, und spielt es sich?
8/10
Spielbar, Cloud-Referenz mit hoher Reasoning-Stufe.
PräsentationMenüs, Anzeigen, Grafik, Ton
8/10
Aufnahme vorhanden.
CodequalitätTests, Struktur, Selbstkorrekturen
8/10
12 Testdateien, kein Reparaturskript.
UmfangWie viel vom Auftrag wurde erfüllt?
8/10
72 Dateien, 9 433 Zeilen.
Diese Bewertung ist ein Vorschlag und von Kai Bennett noch nicht bestätigt. Codequalität und Umfang stützen sich auf ausgezählte Dateien, Quell- und Testzeilen sowie Reparaturskripte im Belegrepo.
Wie sehen Sie das? Die Note oben ist eine persönliche Einschätzung. Hier zählt Ihre, unabhängig davon.
Was schiefging
Es gab zwei Selbstkorrekturen des Modells.
Cloud-Referenz über die Anthropic-API. Das Artefakt liegt vor, die Geschwindigkeit ist nicht vergleichbar gemessen. Die Laufzeit von rund 70 Minuten ist aus der Sitzung notiert, nicht aus einem Protokoll gerechnet.
Bilderkennung
Eigener Testlauf, nicht Teil eines gemessenen Laufs. Cloud-Referenz.
Werte ablesen
46 von 50
Dashboard, 50 prüfbare Angaben
Preisschilder
1 von 4
vollständig richtig gelesen
Erfundene Schilder
5
keins als sicher behauptet
Fallen bestanden
2 von 4
Stellen, die vom Muster abweichen
Vorläufig: der Lösungsschlüssel für die Preisschilder ist noch nicht vollständig gesichert.
Aufgabe 1 · Werte ablesen
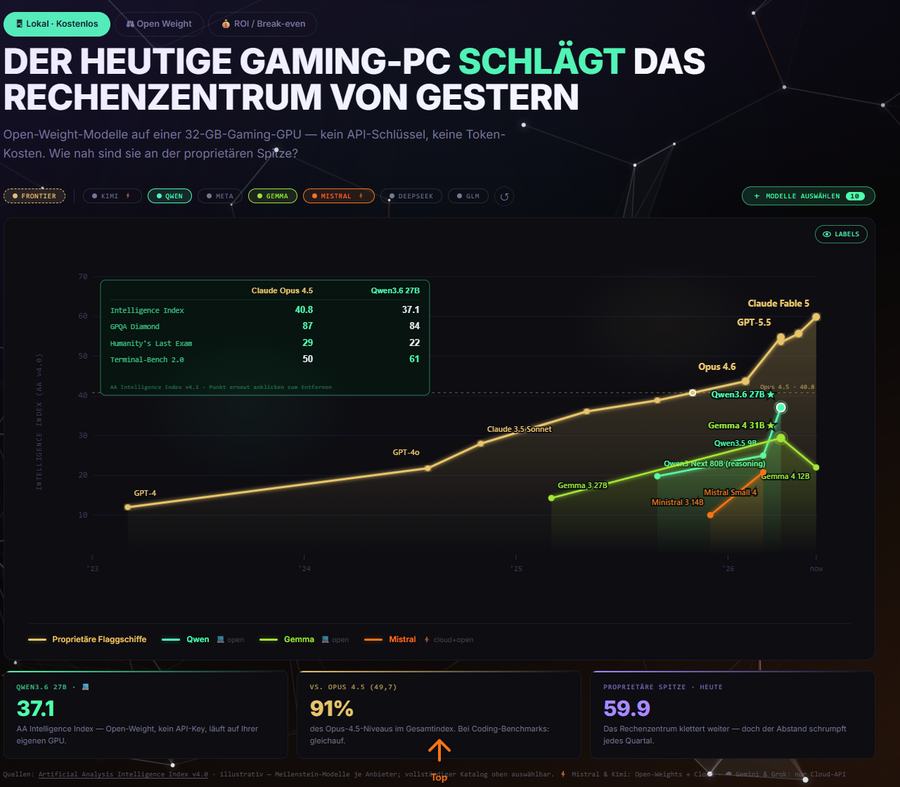
Was das Modell aus der Tooltip-Tabelle gelesen hat
| Claude Opus 4.5 | Qwen3.6 27B | |
|---|---|---|
| Intelligence Index | 40.8 | 37.1 |
| GPQA Diamond | 87 | 84 |
| Humanity's Last Exam | 29 | 22 |
| Terminal-Bench 2.0 | 50 | 61 |
Und aus den Kennzahlkacheln
- QWEN3.6 27B · OPEN 37.1 · AA Intelligence Index — Open-Weight, kein API-Key, läuft auf ihrer eigenen GPU.
- VS. OPUS 4.5 (40,8) 91% · des Opus-4.5-Niveaus im Gesamtindex. Bei Coding-Benchmarks: gleichauf.
- PROPRIETÄRE SPITZE · HEUTE 59.9 · Das Rechenzentrum klettert weiter — doch der Abstand schrumpft jedes Quartal.
Aufgabe 2 · Komplexe Schrifterkennung
Geprüft wird das Lesen von winzigen, schräg stehenden, teils verdeckten Schriften in einem Foto mit über vierzig Objekten, dazu zwei Währungszeichen, die sich bei starker Drehung kaum unterscheiden. Zum Test werden die Preisschilder verwendet.
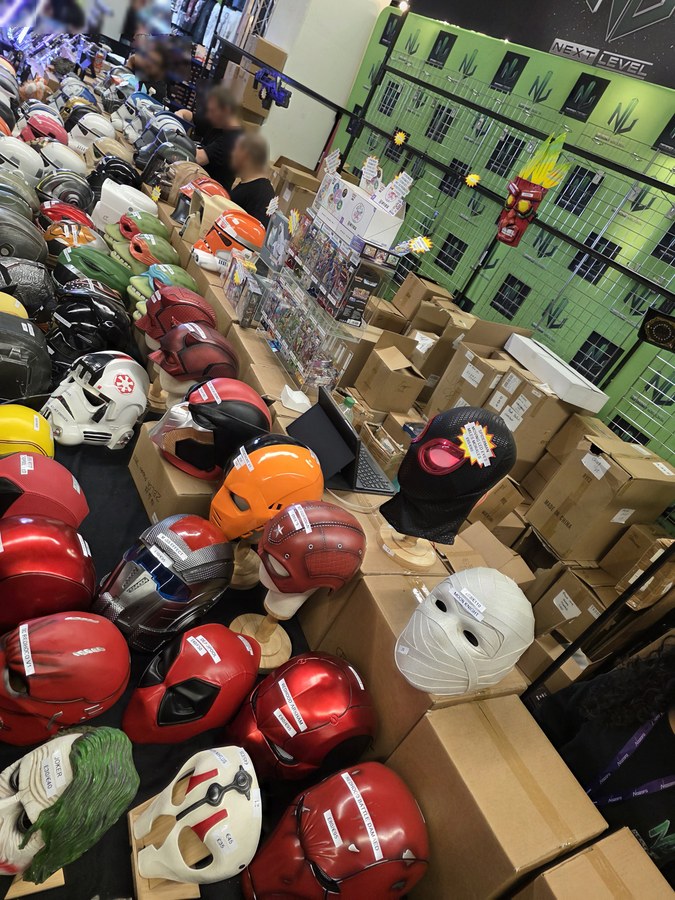
Was das Modell gelesen hat
| Was das Modell dort las | £ | € | Reihenfolge | sicher | |
|---|---|---|---|---|---|
| 1 | MASS EFFECT | nicht lesbar | nicht lesbar | · | nein |
| 2 | JOKER | 30 | 40 | gbp zuerst | nein |
| 3 | ohne Namen | 45 | 35 | eur zuerst | nein |
| 4 | ohne Namen | nicht lesbar | nicht lesbar | · | nein |
| 5 | ohne Namen | nicht lesbar | nicht lesbar | · | nein |
| 6 | ohne Namen | nicht lesbar | nicht lesbar | · | nein |
Das Modell zählte 8 Schilder im Wertungsbereich. Der Lösungsschlüssel steht hier bewusst nicht daneben, sonst könnte ein späteres Modell ihn von dieser Seite ablesen.
Das Modell über die schwierigste Stelle: „Im Diagramm die eng gedrängten Punktbeschriftungen oben rechts (Qwen-, Gemma- und Mistral-Punkte liegen dicht beieinander, Labels überschneiden sich fast). In Bild B die Preisziffern selbst: die Schilder liegen schräg zur Kamera und sind bei mehreren Masken so klein/unscharf abgebildet, dass ich nicht einmal den vollständigen Produktnamen sicher lesen konnte, geschweige denn die Beträge.“
Wo sich das Modell selbst unsicher war (10 Stellen)
- Bild A: erster X-Achsen-Wert — gelesen als '23, könnte auch '22 sein
- Bild A: Klammerwert in Kachel 2 — gelesen als '(40,8)', Ziffer nicht eindeutig
- Bild A: Y-Achsenbeschriftung '(AA v4.0)' im Klammerteil unsicher
- Bild A: Fußzeile unter der Tooltip-Tabelle nur teilweise lesbar
- Bild A: mögliche kleine Zahlen-Abzeichen neben KIMI und MISTRAL im Filter — Ziffern zu klein für eine sichere Lesung
- Bild A: Zusatztext neben dem Mistral-Legendeneintrag nicht sicher entzifferbar
- Bild B: bei den meisten Schildern im Wertungsbereich waren die Pfund-/Euro-Ziffern zu klein bzw. zu schräg fotografiert, um sie ohne Raten zu übernehmen — deshalb dort null statt einer erfundenen Zahl
- Bild B: Reihenfolge £/€ bei mehreren Schildern nicht sicher bestimmbar
- Bild B: genaue Zusatzbezeichnungen der drei 'REDHOOD'-Masken (z. B. V1 / Armor / Battle Damaged / Airman) nicht sicher unterscheidbar
- Bild B: die Abgrenzung des Wertungsbereichs (x bis 700, y ab 950) konnte ich nur optisch schätzen, ohne Koordinatenwerkzeug — einzelne Schilder nahe der Grenze könnten falsch zugeordnet sein
Diese Liste hat das Modell selbst geschrieben, nicht der Auswerter. Sie zählt in die Wertung: ein eingestandenes „nicht lesbar“ kostet einen Punkt, eine erfundene Angabe kostet mehr.
Die vollständige Antwort des Modells als JSON · Die Auswertung dazu steht nicht daneben: sie nennt zu jedem Fehler den richtigen Wert, und damit läge der Lösungsschlüssel offen.
Quellen
- Modellkartedocs.anthropic.com/en/docs/about-claude/models
- Herstellerseitewww.anthropic.com
- Messdaten-Repogithub.com/KaiFelixBennett/local-ai-amd-benchmark
- Quelltext · Moorhuhngithub.com/KaiFelixBennett/local-ai-amd-benchmark/tree/main/benchmarks/sonnet5/moorhuhn
Selbst ausprobieren
- Gewichte laden
- llama-server mit der Startzeile oben starten
- Den Endpunkt in VS Code als eigenes Modell eintragen und den Agenten wählen
Auftrag, Agentdateien und Werkzeuge: Agent Test Harness
Zitieren: Kai Felix Bennett, „Nutzbarkeitstest von lokaler KI auf AMD-Hardware", benchmark.securesight.ai, Lauf sonnet5. Messdaten CC-BY-4.0.
Messdaten CC-BY-4.0, Code MIT.