Welche Modelle bringen welche Ergebnisse in welcher Geschwindigkeit? Keine Standard-Benchmarks, sondern Bilderkennung und agentisches Coding mit VS Code auf lokaler, bezahlbarer AMD-Hardware selbst ausprobiert.
Ich bin Kai Bennett, Softwarearchitekt, und begeistere mich seit September 2025 für lokale KI. Hier teile ich meine Erkenntnisse und Ergebnisse, die ich auf den beiden Geräten gemessen habe.
Zertifizierter Softwarearchitekt (iSAQB CPSA-F/A) · Mitgründer von securesight.ai
Ich habe mit den beiden Modellen die längsten agentischen autonomen Aufträge
von bis zu 13,6 h und gleichzeitig sehr gute Ergebnisse bei nutzbarer
Geschwindigkeit von über 20 t/s im Median. Das ist für mich auf dieser
Hardware, Stand September 2026, der beste Kompromiss aus Qualität und
Geschwindigkeit, ohne Token bezahlen, ohne Abhängigkeit zu Cloud Anbietern
und ohne meine Daten zu teilen.
Qwen3.8-27B UD-Q4_K_XL mit über 30 t/s im Schnitt, bei langem Kontext noch um die 30. Das ist eine gut brauchbare Geschwindigkeit, und das, obwohl es sich um ein Dense-Modell handelt, bei dem alle 27 Milliarden Parameter gleichzeitig aktiv sind.
Windows 11 Pro 26200 · Treiber 32.0.31021.5001 · Vulkan-Heap 98.123 MiB
Software
llama.cpp über Vulkan
Alle Läufe auf llama.cpp mit dem Vulkan-Backend, kein ROCm, keine BIOS-Änderung. Als Server im lokalen Netz, angebunden an VS Code Copilot Chat als Custom Endpoint.
Ich habe mit den beiden Modellen die längsten agentischen autonomen Aufträge von
bis zu 13,6 h und gleichzeitig sehr gute Ergebnisse bei nutzbarer Geschwindigkeit
von über 20 t/s im Median. Das ist für mich auf dieser Hardware, Stand September
2026, der beste Kompromiss.
AMD AI MAX 395 (AMD Halo) · GMKtec EVO-X2
Qwen3.8-Flash-Next
UD-Q4_K_XL · MTP, Shared-Q8_0, n-max 2
t/s Median
21,76
Laufzeit
13,6 h
Anfragen
459
Nicht das schnellste und auch nicht die höchste Qualität, aber es nutzt die Vorteile des AMD Strix Halo, also verwendet den gesamten VRAM, beinhaltet bereits die Qwen 4 Architektur und liefert mit stabiler Geschwindigkeit gut ab.
Das erste Modell, das ich auf einer GPU mit 24–32 GB VRAM auch zum Coding empfehlen würde. Es läuft in Q4 stabil agentisch über Stunden, schreibt Tests und reviewt sich selbst. Wenn ich ein Modell im Bereich bis 32 GB VRAM empfehlen würde, dann wäre es definitiv dieses.
Videos, Bilderkennung und Messwerte auf den Detailseiten
Zum Beispiel ein vom Retro Spiel „Moorhuhn“ inspirierter Test, der mit nur einem
Prompt erstellt wurde, zum selbst ausprobieren. Alle Messwerte inklusive der
Geschwindigkeit und der verbrauchten Token. Auch Bilderkennung wird getestet, eine
wichtige Fähigkeit der Modelle damit sie ihre eigenen Ergebnisse ansehen und
verbessern können.
Dafür wurde ein Agent in Visual Studio Code konfiguriert, der die entsprechenden
Anweisungen enthält.
14 von 14
Detailseiten gebaut·0
folgen
/
Tippen zum Filtern · ↑ ↓ zum Wählen · Eingabe öffnet die Detailseite
Jedes Modell steht einmal, mit allen Aufgaben, die es bearbeitet hat. Wo mehrere Läufe
vorliegen, ist der Median über alle gewerteten Antworten dieser Läufe zusammen gerechnet,
nicht aus den einzelnen Medianen gemittelt; Token und Minuten sind Summen. Die Zahlen je
Lauf stehen auf der Detailseite. Mio. Token verbraucht ist die Zahl, die ein kostenpflichtiger Anbieter in Rechnung
gestellt hätte: Eingabe plus Ausgabe, wobei jede einzelne Anfrage mit ihrem vollen Kontext
zählt und nicht nur mit dem, was neu hinzukam. Ein Agentenlauf schickt denselben Verlauf
hunderte Male mit, deshalb liegt die Eingabe um ein Vielfaches über der Ausgabe. Kurze
Antworten sind mitgezählt, auch die, die in den Geschwindigkeitswert nicht eingehen. Die
Aufteilung in Eingabe und Ausgabe steht im Tooltip jeder Zeile.
Das beste Ergebnis bisher
Ein 13,5h Lauf erstellt ein komplettes kleines Spiel, u.a. inklusive Konfigurationen und Spielfortschritt.
Qwen3.8-Flash-Next auf dem AMD AI MAX 395, 177 Milliarden Parameter, davon rund
sechs aktiv. 459 Requests, 786 506 erzeugte Token, kein einziges Eingreifen.
Grafiken, Menüs, Töne, Backend: alles mitgeneriert. Klar können das die großen
Modelle auch, aber ich fand das Ergebnis in Teilen sogar besser als von Sonnet 5,
und es läuft auf Hardware für um die 2 600 € (z. B. Bosgame M5).
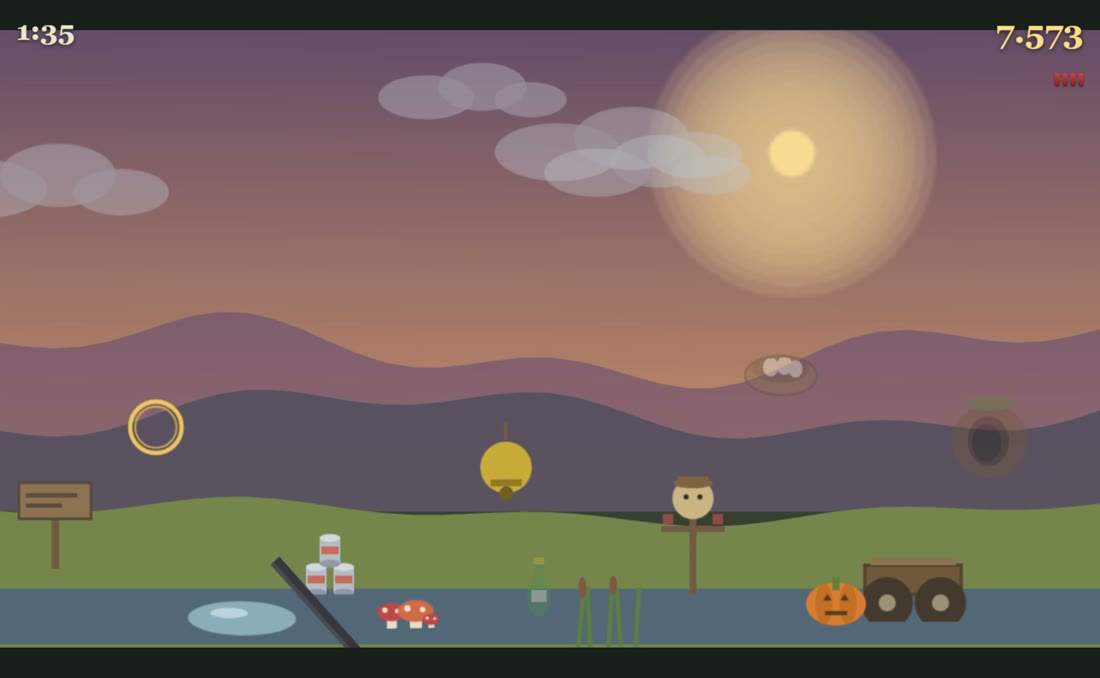
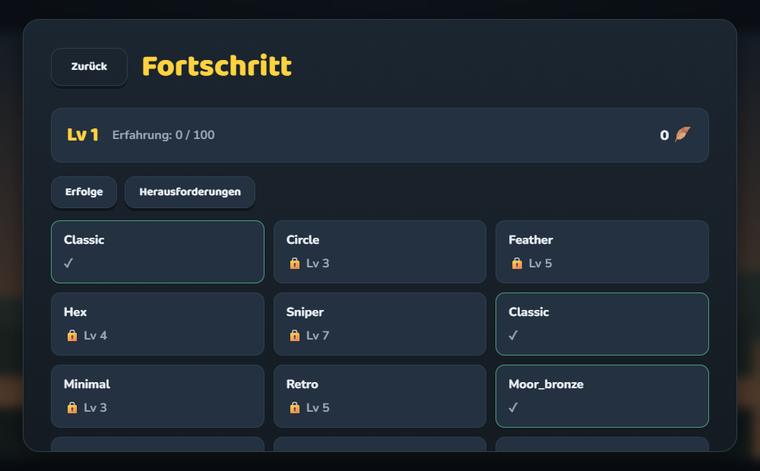
Aufnahmen aus den ausgelieferten Builds: Menüs, Spielmodi, Punktesystem, Freischaltungen.
Moorland Mayhem — Featherstorm · gebaut von Qwen3.8-27B UD-Q4_K_XL auf der
Radeon AI PRO R9700 · ein einziger Auftrag. Einstellungen, Statistiken, eine volle
Runde und die Auswertung. Ungeschnitten, 1 Minute 44.
Qwen3.6-27B Q6Clair Obscure · Kampf, eigene AufnahmeQwen3.6-27B Q6Moorhuhn · 1.125 PunkteLaguna S 2.1 · AMD AI MAX 395Clair Obscure · Rundenkampf
Clair Obscure — Expedition 33 · Qwen3.8-27B UD-Q6 auf der Radeon AI PRO
R9700 · Nachtszene mit Dialog, Portal, Kampfarena mit Zielsystem, Fähigkeitenmenü
und Titelbild. Ungeschnitten, 3 Minuten 41.
Referenzlauf
Dieselbe Aufgabe, anderes Modell.
Qwen3.8-Flash-Next auf dem AMD AI MAX 395 (AMD Halo), 177 Milliarden Parameter
gesamt, davon rund sechs aktiv. Kampfarena mit Magiekreis, Aktionsmenü,
Statusleisten und Zaubereffekten.
Clair Obscure — Expedition 33 · Qwen3.8-Flash-Next UD-Q4_K_XL auf dem
AMD AI MAX 395 (AMD Halo) · ungeschnitten, 3 Minuten 16.
Agentische Entwicklung
Single Shot. 13,5h.
Das Modell läuft im lokalen Netz und ist in VS Code Copilot Chat als Custom
Endpoint hinterlegt, also genau dort, wo die meisten Entwickler ohnehin sind.
Mit Tool Use schreibt es Tests, legt Dateien und Ordner an, erstellt Screenshots und
Playwright-Tests, um sich selbst zu prüfen.
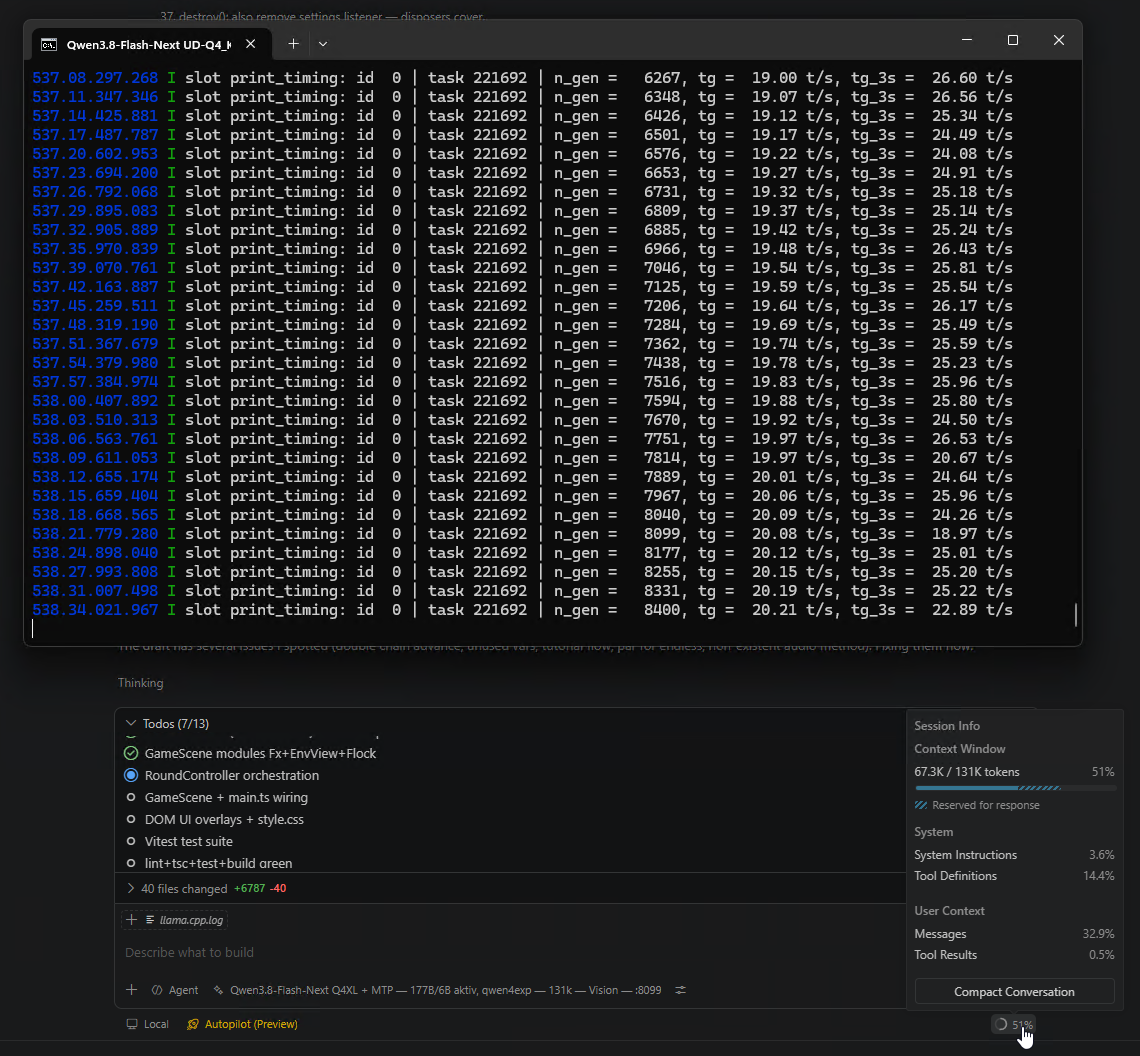
Der Lauf ist inzwischen fertig: 13 Stunden 36 Minuten an einem einzigen
Auftrag, 459 Anfragen, 786 506 erzeugte und 1 051 292 eingelesene
Tokens. Rechnet man den zwischengespeicherten Kontext mit, hat das Modell dabei
24,9 Millionen Tokens gelesen. Kein einziges Mal wurde der Kontext
abgeschnitten. Der Höchststand lag bei 98 109 von 131 072.
Das Bild zeigt einen Zwischenstand nach 8 Stunden 47 Minuten: das siebte von
dreizehn Arbeitspaketen, 40 geänderte Dateien, das Kontextfenster bei 51 Prozent.
Qwen3.8-Flash-Next Q4XL + MTP · 177B/6B aktiv · 131k · Vision · :8099
Oben die Serverkonsole, unten der Agent: 40 geänderte Dateien (+6787/−40),
Kontextfenster 67,3 K von 131 K.
1.835.623Tokens erzeugt
869gemessene Antworten
42 hLaufzeit
Vision
Bilderkennung
Viele lokale Modelle können Bilder erkennen. Geprüft wird an eigenen Bildern,
um zu testen, wie gut die Bilderkennung funktioniert.
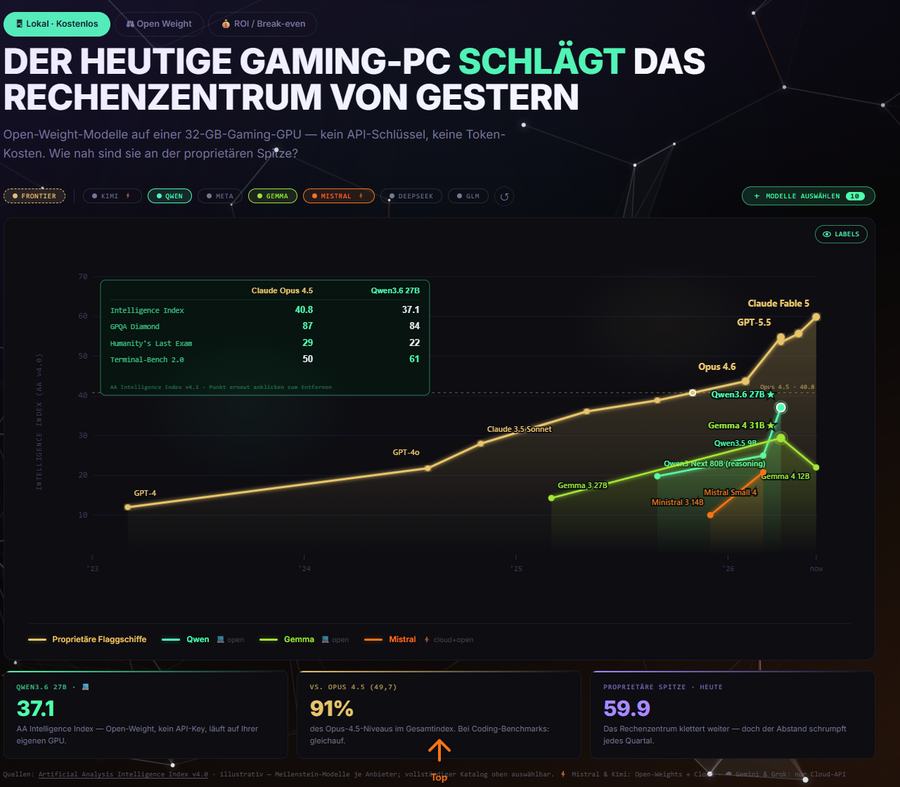
Werte ablesenEin eigenes Dashboard: Tooltip-Tabelle, KPI-Kacheln, aktive
Filter, Fußnoten. Das Modell gibt sie als JSON aus und zeichnet das Diagramm als
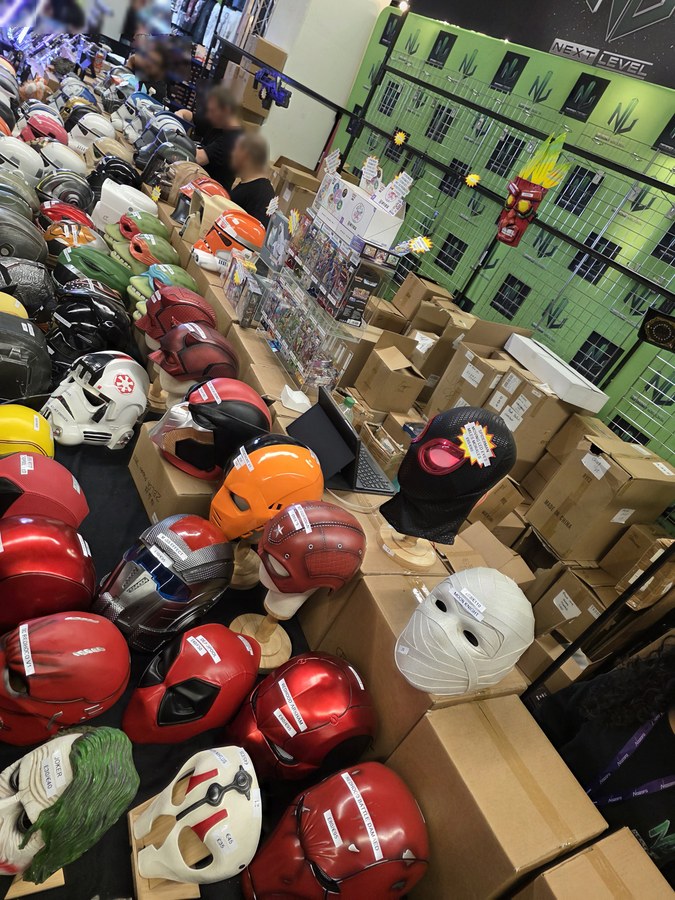
SVG nach.Im Gewühl lesenEin Messestand mit über vierzig Objekten. Gezählt wird, wie
viele Preisschilder korrekt gelesen werden, und wie viele erfunden.
Was die Modelle erkannt haben
In beiden Bildern weicht jeweils genau eine Stelle vom Muster ab. Das ist für die
Modelle eine Herausforderung, bei der sie Details erkennen müssen. Diese vier
Stellen werden deshalb getrennt angegeben.
Geprüft wird
Qwen3.8-27BUD-Q4_K_XL · Radeon AI PRO R9700
Qwen3.6-27BUD-Q6_K_XL · Radeon AI PRO R9700
Qwen3.5-122B-A10BUD-Q4_K_XL · AMD AI MAX 395 (AMD Halo) · GMKtec EVO-X2
Sonnet 5— · Cloud-Referenz
Werte richtig ablesen
44 von 50
50 von 50
30 von 50
46 von 50
Zeile Terminal-Bench 2.01
erkannt
erkannt
erkannt
erkannt
Kachelwert 40,72
erkannt
erkannt
nicht erkannt
nicht erkannt
Preisschild JOKER3
nicht erkannt
erkannt
nicht erkannt
erkannt
Weiße Maske, ohne Namen4
nicht erkannt
erkannt
nicht erkannt
Reihenfolge erkannt, Beträge vertauscht
Preisschilder vollständig richtig5
2 von 4
4 von 4
0 von 4
1 von 4
Erfundene Schilder6
4 · 1 als sicher behauptet
0
0
5 · keins als sicher behauptet
Zeile Terminal-Bench 2.0 In allen anderen Zeilen der Tabelle steht links der größere Wert. In dieser einen
nicht. Wer die Tabelle überfliegt und das Muster fortschreibt, dreht sie um.
Kachelwert 40,7 Die Kachel nennt für dasselbe Modell 40,7, der Tooltip nennt 40.8. Beide Zahlen
stehen so im Bild. Wer sie angleicht, hat geglättet statt gelesen.
Preisschild JOKER Bei allen anderen Schildern ist der Pfundpreis höher als der Europreis. Bei diesem
einen ist es umgekehrt.
Weiße Maske, ohne Namen Bei allen anderen Schildern steht das Pfund oben und der Euro darunter. Bei diesem
einen ist die Reihenfolge vertauscht.
Preisschilder vollständig richtig Gewertet nur im festgelegten Bildausschnitt, in dem die Schilder flach zur Kamera
liegen. Richtig heißt: Name sinngemäß getroffen, beide Beträge exakt, Reihenfolge
der Währungen korrekt. Zwei von drei genügt nicht.
Erfundene Schilder Genannte Schilder, die im Lösungsschlüssel nicht vorkommen. Getrennt ausgewiesen
ist, wie viele davon als sicher behauptet wurden. Ein eingestandenes „nicht lesbar“
kostet einen Punkt, eine erfundene Angabe kostet mehr.
Vorläufig. Der Lösungsschlüssel für die Preisschilder ist erst zu vier von
sieben Schildern gesichert. Präzision und Recall werden nur gegen diese vier
gerechnet und ändern sich, sobald der Rest bestätigt ist. Die vier Fallen sind davon
nicht betroffen, sie sind gesichert.
Geschwindigkeit
33,7t/s
So schnell schreibt der schnellste Lauf.
Median über 82 Antworten. Nicht die maximal erreichte
Geschwindigkeit ist entscheidend, sondern die Geschwindigkeit, die man bei der
Umsetzung einer Aufgabe im Durchschnitt erreicht.
Hardware
R9700AI MAX 395Cloud, keine lokale GeschwindigkeitPareto-FrontQualitätsachse vorläufig
Kontexttiefe
Benchmark-Geschwindigkeiten verzerren das Bild.
Denn sie messen fast immer bei kurzem Kontext. Bei echter Nutzung wächst der Kontext
kontinuierlich, und die Geschwindigkeit sinkt stetig. Daher zeigen wir hier
Median-Geschwindigkeiten und den Verlauf abhängig von der Kontextgröße.
Decode · Qwen3.8-Flash-Next · AMD AI MAX 395 (AMD Halo)
Rohprotokoll
Auf der R9700 fällt die Prefill-Rate zwischen 8 K und 164 K um den Faktor 4,2.
Rechts die Decode-Rate von Qwen3.8-Flash-Next aus dem Moorhuhn-Lauf: 346 Antworten ab
200 Tokens, jede mit ihrem Kontextstand aus dem Protokoll, in sechs gleich großen
Gruppen, gemessen zwischen 34 K und 71 K Kontext, also in dem Bereich, wo es bei der
alltäglichen Nutzung wichtig ist. Über diese Spanne fällt sie um den
Faktor 1,18. Das Modell lief besonders stabil und zuverlässig.
Feinabstimmung
Its all about settings
Die Parameter der Modelcards sind (für AMD) nicht immer optimal. Zum Beispiel
folgende drei habe ich geändert.
spec-draft-n-max · Laguna S 2.1
15 → 3
Verringerung von „spec-draft-n-max“ erzeugt mehr Durchsatz
Mit dem dokumentierten --spec-draft-n-max 15 fällt der Decode auf
8,1 t/s, unter die 20,55 ohne jede Spekulation. Mit 3 steigt
er auf 27,9.
Ohne das Setting zu Reduktion der Wahrscheinlichkeit für Wiederholungen endet die Antwort nicht
Mit presence_penalty 0.0 lief eine Aufgabe bis ans Kontextende:
32 768 Tokens, ohne Abschluss. Dieselbe Aufgabe braucht 201 Token mit der
aktivierten Einstellung.
Gemessen werden zwei verschiedene Dinge. Der Lauf zeigt Geschwindigkeit,
Durchhaltevermögen und ob am Ende etwas Lauffähiges steht. Die Detailseite
zeigt: Gestaltungsvermögen, Bilderkennung, und ob es sich an einen Vertrag hält,
ohne zu erfinden.
01
Die Aufträge
Zwei Aufträge, aus denen alle Ergebnisse dieser Seite entstanden sind.
Unverändert, so wie sie den Modellen vorlagen. Sie sind absichtlich
gegensätzlich gebaut.
15 KB · Tiefe statt Breite. Ein einziger Kampf, aber mit Parieren und
Ausweichen in engen Zeitfenstern. Der Auftrag nennt diese Schicht selbst
den schwersten Teil.
Der eine Auftrag lässt sich durch Fleiß bestehen, der andere nicht.
02
Die Agenten
Ein Agent für VS Code
Copilot Chat. Nach .github/agents/ legen, dann steht er im Chat zur Auswahl.
Der Bildtest. Er bekommt bewusst kein Terminal, damit das Modell die Prüfbilder ansieht, statt sie sich mit einer Bildbibliothek zurechtzuschneiden.
llama-server spricht die OpenAI-Schnittstelle. VS Code nimmt solche Endpunkte
über „Bring your own key“ entgegen, auch ohne Copilot-Abo und ohne Anmeldung.
Die Startparameter je Lauf stehen unter Modellkarten.
Jeder Lauf hat eine eigene Detailseite mit denselben elf Abschnitten: Architektur,
Messwerte, Artefakt, Bilderkennung, Tempo, Konfiguration, Qualität, Fehler,
Quellen, Nachbau.
Drei Zahlen für denselben Speicher. Der AMD AI MAX 395 hat 128 GiB unified
LPDDR5X, keine 128 GB VRAM. Windows sieht 63,6 GiB, die BIOS-Reservierung beträgt
64,4 GiB, Vulkan meldet 98.123 MiB.
Nachprüfbarkeit
Kontrolle ist gut
Logs und Messwerte liegen im öffentlichen Repo und wurden auf den beiden genannten
Systemen gemessen. Natürlich können die Zahlen je nach Hardware- und Software-Setup
bei dir etwas abweichen.
1
Rohdaten im öffentlichen Repo
Die Serverprotokolle von llama.cpp und die Messtabellen liegen unverändert in
evidence/, zusammen rund 3,8 MB, mit Prüfsummen. Jede Modellkarte
und jede Tabellenzeile verlinkt genau die Datei, aus der ihre Zahlen stammen.
2
Messgrenzen
Gewertet wird jede Antwort ab 200 Tokens: kürzere erzeugen im Protokoll
Ausreißer bis 1 000 000 t/s, ein Token in nahezu null Millisekunden. Perzentile
nach Rangplatz, nicht interpoliert.
3
Nachprüfbarkeit
Wer den Zahlen nicht glaubt, lädt das Repo und lässt verify_runs.py
laufen. Es rechnet jeden Wert aus dem Rohprotokoll nach und meldet jede
Abweichung. Derzeit: null.
Manche Messläufe haben leider nicht alle Zahlen. Der Clair-Obscure-Lauf von
Qwen3.6-27B und die drei Cloud-Modelle führen deshalb keine Geschwindigkeit. Die
Artefakte gibt es, die Messung nicht.
verify_runs.pylogs/
Quelltext
Quellen
Zuerst das Repo zu dieser Seite: dort liegen alle Protokolle, Belege und der
Quellcode der Benchmarks. Darunter die Werkzeuge, die bei diesen Messungen im
Einsatz waren.